Pendahuluan: mengapa memilih skincare bukan lagi tebak-tebakan
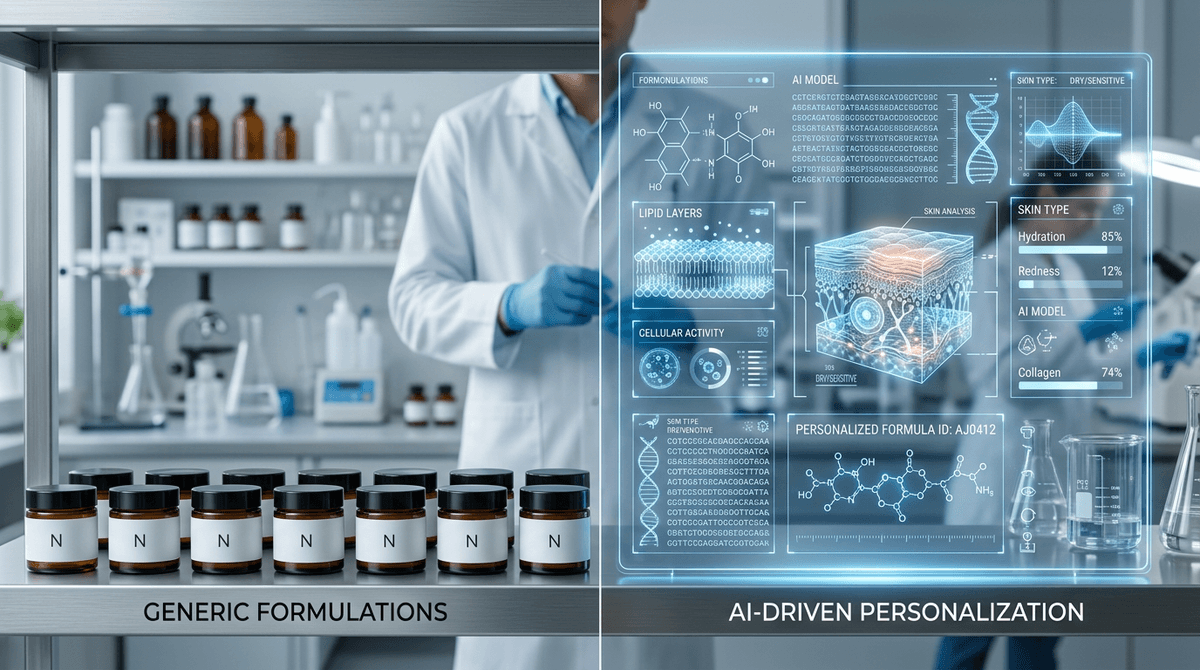
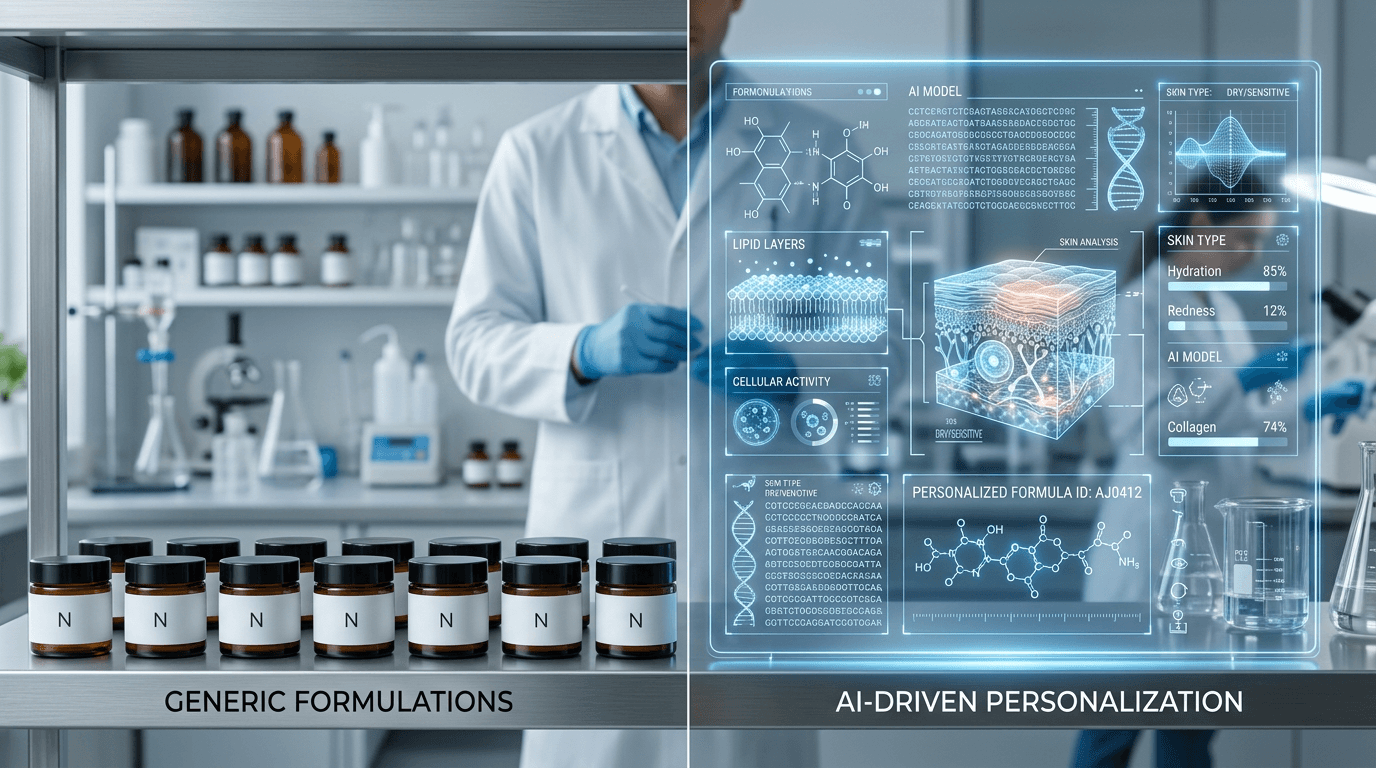
Alur kerja klasik pengembangan formula biasanya begini: seorang formulator memilih bahan aktif yang "cocok untuk semua orang" — Niacinamide untuk bekas jerawat, Retinol untuk kerutan, Hyaluronic Acid untuk hidrasi — lalu menyusun krim berdasarkan template yang sudah terbukti pada klien sebelumnya. Setelah itu masuk tahap uji coba: tes pada panel 15-20 relawan, dua-tiga iterasi formula, menunggu hasil 8-12 minggu. Jika kulit bereaksi tak terduga — iritasi, komedogenik, atau tidak ada efek sama sekali — siklusnya diulang dari awal. Satu produk akhir bisa memakan waktu 6 bulan hingga satu setengah tahun, dan anggaran pengujian untuk satu lini besar dengan mudah melebihi biaya pengembangan formulanya sendiri.
Masalahnya bukan pada kompetensi formulator, melainkan pada logika pendekatannya sendiri: lini bahan aktif yang universal meratakan respons kulit, padahal secara fisiologis kulit sangat heterogen. Fungsi barrier, mikrobioma, laju sekresi sebum, kecepatan deskuamasi, dan sensitivitas terhadap iritan bisa berbeda jauh antar orang dengan "tipe kulit" yang sama di atas kertas — sampai-sampai Salicylic Acid 2% yang sama bisa menghilangkan peradangan dalam dua minggu pada satu klien, tapi memicu kekeringan dan pengelupasan hanya dalam tiga hari pada klien lain.
Di mana model pemilihan tradisional gagal
Pendekatan coba-coba bertumpu pada tiga asumsi, dan masing-masing lemah secara statistik:
- Tipe kulit sebagai kategori — pembagian "kering/berminyak/kombinasi" mengabaikan puluhan biomarker (kehilangan air transepidermal, pH permukaan, kepadatan folikel pilosebasea) yang sebenarnya menentukan respons terhadap bahan aktif;
- Efikasi yang dianggap berlaku untuk semua orang — efikasi bahan aktif dalam studi klinis (menurut Draelos, 2018, efikasi Niacinamide bervariasi dari 40% hingga hampir nol pada subkelompok panel yang berbeda) tidak menjamin hasil yang sama pada kulit spesifik seseorang;
- Formula yang statis — resep ditetapkan sekali untuk selamanya, padahal kulit berubah mengikuti musim, siklus hormonal, dan faktor eksternal — sementara formulanya tidak.
Akibatnya, industri kosmetik selama bertahun-tahun mengompensasi ketidakpastian ini dengan jumlah SKU: lini 8-10 krim "untuk kebutuhan berbeda" alih-alih satu formula yang benar-benar disesuaikan dengan kasus spesifik.
Apa yang berubah dengan penerapan jaringan saraf tiruan
Tesis artikel ini sederhana: machine learning mengubah pemilihan bahan aktif dari tebakan kategoris menjadi tugas prediksi berbasis data. Alih-alih bertanya "bahan aktif apa yang biasanya membantu jerawat," model ini menjawab "kombinasi bahan aktif apa yang memberikan efek maksimal untuk profil kulit spesifik — dengan tingkat sebum, fungsi barrier, dan riwayat respons terhadap produk sebelumnya yang diketahui." Untuk itu digunakan tiga kelas model:
- model prediktif berbasis data klinis dan konsumen (regresi, gradient boosting) yang memperkirakan probabilitas iritasi atau efikasi suatu bahan aktif untuk profil tertentu;
- model generatif yang mengusulkan kombinasi konsentrasi bahan aktif dalam rentang teknologi yang diizinkan;
- computer vision untuk menganalisis foto kulit dan mengekstrak fitur (kepadatan pori, kemerahan, bercak pigmentasi) yang menjadi input bagi dua model sebelumnya.
Ini bukan pengganti kimia formula ataupun pembatalan mekanisme biokimia — Retinol tetap membutuhkan waktu adaptasi stratum korneum, dan Ascorbic Acid tetap tidak stabil pada pH di atas 3,5. Yang berubah bukan sifat dasar bahan aktifnya, melainkan ketepatan menentukan konsentrasi dan kombinasi yang tepat sejak percobaan pertama.
Di bagian-bagian berikutnya kita akan membahas data apa yang dibutuhkan model untuk pemilihan bahan aktif yang akurat, bagaimana algoritma mencocokkan bahan aktif dengan tujuan formula (jerawat, pigmentasi, barrier, penuaan), dan di mana teknologi ini sudah diterapkan dalam pengembangan kosmetik nyata — dengan contoh yang bisa diakses tanpa platform R&D korporat yang mahal.
Bagaimana jaringan saraf tiruan "melihat" kulit: dari foto ke profil digital
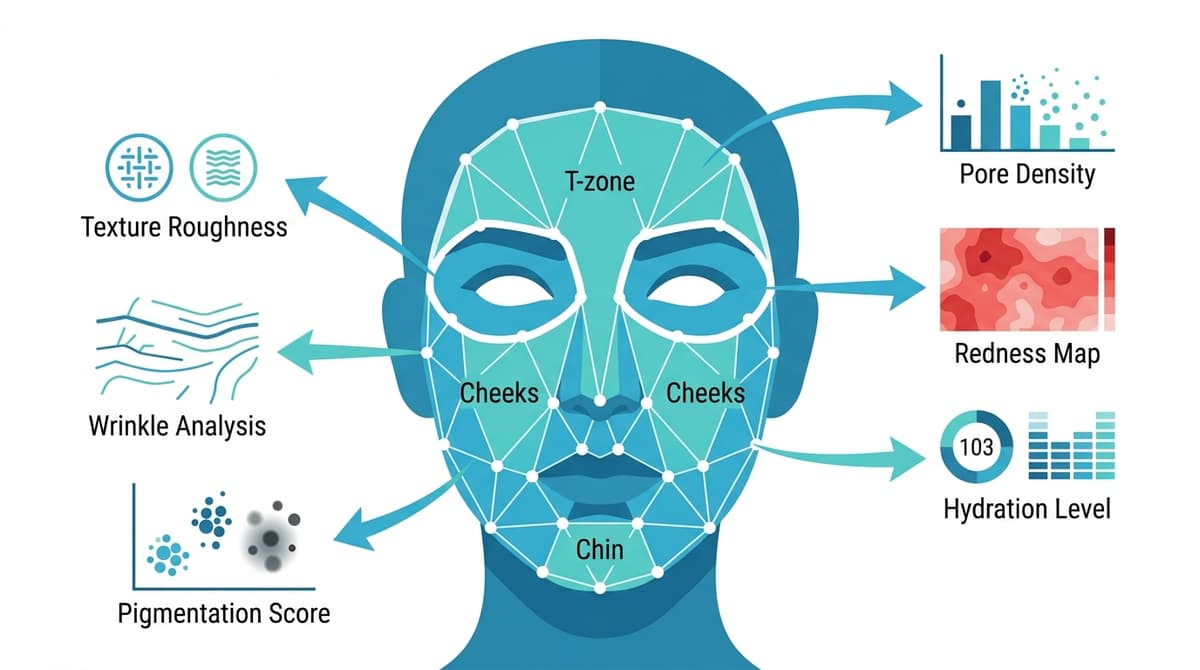
Sebelum algoritma bisa mengusulkan satu formula pun, ia harus mengubah foto wajah menjadi sekumpulan angka. Proses ini disebut ekstraksi fitur (feature extraction), dan kualitasnya menentukan apakah klien menerima rekomendasi berdasarkan kondisi kulit yang sesungguhnya — bukan template rata-rata "untuk semua orang".
Computer vision memproses gambar kulit melalui beberapa tahap berurutan, masing-masing menyelesaikan tugas sempitnya sendiri.
Tahap 1: segmentasi zona wajah
Hal pertama yang dilakukan sistem adalah memetakan wajah ke dalam zona anatomis: zona T, pipi, area periorbital, lipatan nasolabial, dagu. Ini penting karena kulit di zona berbeda berperilaku berbeda bahkan pada orang yang sama: zona T bisa menunjukkan tanda-tanda berminyak dengan pori melebar, sementara pipi menunjukkan dehidrasi dan pengelupasan. Tanpa segmentasi, model akan merata-ratakan data ini dan menghasilkan rekomendasi yang kontradiktif.
Segmentasi dilakukan menggunakan convolutional neural network (CNN) yang dilatih pada basis data gambar dermatologis yang sudah dianotasi. Model menemukan titik kunci wajah (landmark) — biasanya 68-468 titik, tergantung arsitekturnya — lalu membangun mask zona dari titik-titik tersebut. Akurasi pemetaan semacam ini pada model modern mencapai 95-98% dengan pencahayaan terkontrol (menurut Chen et al., 2021).
Tahap 2: deteksi fitur spesifik
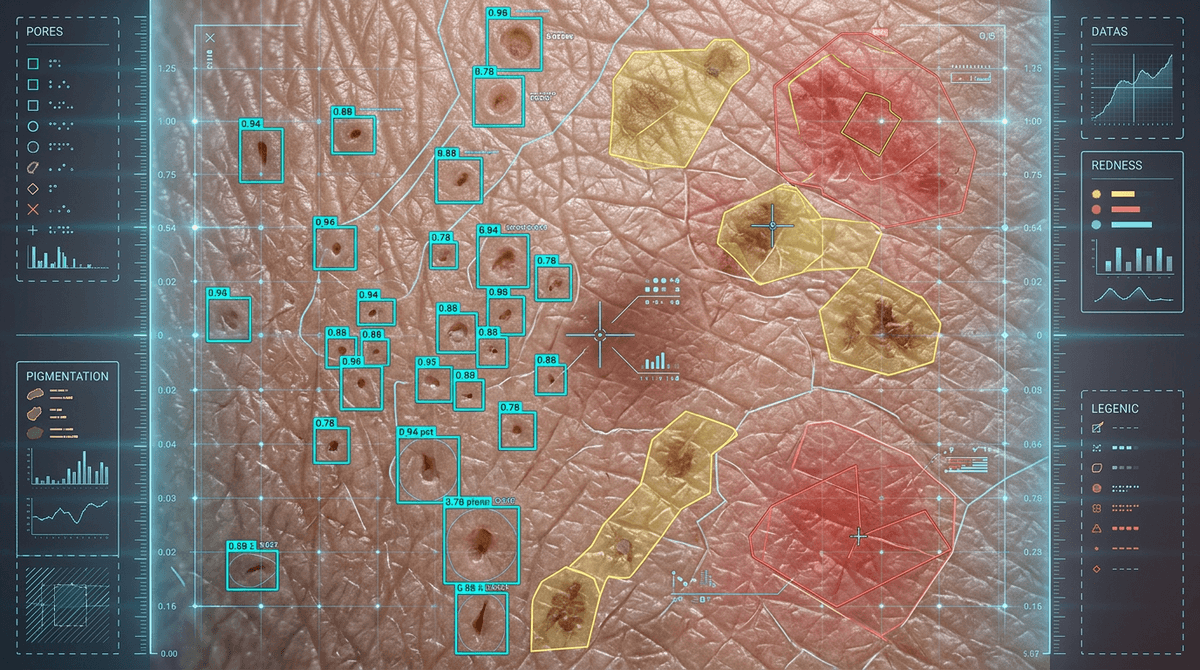
Di dalam setiap zona, algoritma mencari pola visual spesifik yang diubah menjadi metrik terukur:
- Pori — dideteksi sebagai bintik gelap bulat lokal dengan diameter tertentu (biasanya 50-200 mikron setelah konversi piksel); dihitung kepadatan per cm² dan ukuran rata-ratanya
- Kemerahan (eritema) — analisis kanal merah RGB dan deviasinya dari warna dasar kulit; dibangun peta intensitas eritema dalam skala tertentu
- Sebum dan kilap — ditentukan melalui analisis pantulan specular (kilau) pada gambar; semakin tinggi kepadatan dan kecerahan kilau, semakin tinggi perkiraan tingkat sekresi sebum
- Kerutan dan garis lipatan — deteksi struktur linear menggunakan filter tipe Gabor atau Frangi yang menonjolkan garis gelap memanjang dengan latar tekstur yang lebih terang
- Pigmentasi dan bekas jerawat — pengelompokan bercak gelap berbentuk tak beraturan, dibedakan dari pori berdasarkan ukuran dan kontur
Setiap fitur ini tidak sekadar ditandai sebagai "ada/tidak ada" — melainkan mendapat nilai numerik: indeks kepadatan, derajat keparahan, luas area yang terdampak dalam persentase dari total area segmen.
Tahap 3: normalisasi dan konversi menjadi vektor fitur
Data mentah dari foto sangat bergantung pada kondisi pengambilan gambar: pencahayaan, sudut kamera, suhu warna layar. Karena itu, sebelum dimasukkan ke model pemilihan bahan aktif, data melewati normalisasi — penyesuaian ke satu skala yang invarian terhadap kondisi pengambilan gambar. Untuk ini sering digunakan kalibrasi terhadap kartu warna referensi (color checker) atau zona wajah referensi dengan karakteristik yang sudah diketahui (misalnya sklera mata sebagai referensi warna putih).
Setelah normalisasi, semua fitur visual dikumpulkan menjadi satu vektor fitur — kumpulan angka terurut, di mana setiap posisi mewakili parameter tertentu: kepadatan pori di zona T, indeks eritema di pipi, kedalaman kerutan nasolabial, dan seterusnya. Vektor semacam ini biasanya berisi 30 hingga 150 parameter, tergantung tingkat detail modelnya.
| Fitur visual | Metode deteksi | Parameter profil hasil akhir |
|---|---|---|
| Pori | Deteksi blob, kontras lokal | Kepadatan per cm², diameter rata-rata |
| Kemerahan | Analisis RGB/LAB, peta eritema | Indeks peradangan 0-100 |
| Sebum | Analisis kilau specular | Indeks kilap berminyak per zona |
| Kerutan | Filter Gabor/Frangi | Kepadatan dan kedalaman garis |
| Pigmentasi | Pengelompokan bercak gelap | Luas dan kontras bercak |
Vektor numerik inilah — bukan fotonya — yang diteruskan ke model pemilihan bahan aktif. Model tidak lagi "melihat" wajah, melainkan bekerja dengan data terstruktur: membandingkan profil klien dengan basis data pelatihan, tempat kombinasi fitur serupa pernah dikaitkan dengan formula tertentu dan efikasinya. Pencocokan ini dibahas di bagian berikutnya.
Kimia kompatibilitas: mengapa tidak semua bahan aktif boleh dicampur
Bahkan bahan aktif yang sudah dipilih dengan tepat untuk tipe kulit tertentu bisa saja tidak bekerja — atau bahkan merugikan — jika dalam formula ia "bertetangga" dengan bahan lain yang secara biokimia berkonflik. Sebelum AI mengusulkan kombinasi bahan, ia harus memodelkan puluhan interaksi tersembunyi: kompetisi untuk reseptor yang sama, perubahan pH lingkungan, ketidakstabilan oksidatif, adsorpsi kompetitif pada barrier lipid. Inilah "kimia kompatibilitas" — lapisan batasan tak kasatmata yang menentukan ruang formulasi apa saja yang sebenarnya tersedia.
Retinol dan AHA: konflik mekanisme regenerasi
Retinol bekerja dengan mengikat reseptor nuklir RAR/RXR, memicu ekspresi gen yang bertanggung jawab atas proliferasi keratinosit. Alpha Hydroxy Acids (asam glikolat, asam laktat) bekerja berbeda — mereka memutus ikatan ionik antar korneosit di stratum korneum, mempercepat eksfoliasi mekanis. Masalahnya bukan karena kedua mekanisme ini "saling bertentangan" — melainkan karena efeknya saling menumpuk, dan justru itu yang berbahaya. Penggunaan bersamaan retinol (bahkan pada konsentrasi 0,3%) dan AHA di atas dosis 5% secara statistik signifikan meningkatkan kehilangan air transepidermal (TEWL) dan frekuensi eritema, sebagaimana ditunjukkan dalam studi Kong et al. (2021). Barrier tidak sempat pulih di antara dua siklus regenerasi yang dipercepat.
Lapisan kompleksitas tambahan adalah pH. Retinol stabil pada rentang pH 5,5-6,5, sedangkan efikasi AHA turun drastis di atas pH 4. Formula yang mencoba "bertahan" di dua lingkungan sekaligus biasanya kehilangan stabilitas untuk kedua bahan aktif tersebut: retinol lebih cepat teroksidasi, dan asamnya tidak terdeprotonasi cukup untuk bisa menembus stratum korneum.
Vitamin C dan niacinamide: mitos yang masih bertahan hingga kini
Kekhawatiran klasik — L-Ascorbic Acid dan Niacinamide disebut-sebut membentuk niasin dan menyebabkan kemerahan. Ini hanya benar jika campurannya dipanaskan di atas 60°C dalam medium air dengan inkubasi berkepanjangan — kondisi yang tidak relevan untuk emulsi kosmetik jadi pada suhu ruang. Menurut Wohlrab & Kreft (2014), reaksi transamidasi antara kedua molekul ini pada kondisi fisiologis berlangsung sangat lambat sehingga tidak menimbulkan iritasi yang bermakna secara klinis. Meski begitu, model AI perlu memperhitungkan bukan reaksinya sendiri, melainkan kondisi yang mempercepatnya: proses produksi, suhu penyimpanan, pH akhir formula jadi. Jika krim diformulasikan dengan L-Ascorbic Acid pada pH 3,5 (optimum stabilitas untuk bentuk vitamin C ini), penambahan niacinamide dalam konsentrasi tinggi menciptakan sistem buffer yang tidak homogen, di mana sebagian molekul bergeser ke zona pH yang tidak optimal.
| Bahan aktif | pH optimal | Pasangan yang berkonflik | Mekanisme konflik |
|---|---|---|---|
| Retinol | 5,5-6,5 | AHA/BHA >5% | Peningkatan kumulatif deskuamasi, kenaikan TEWL |
| L-Ascorbic Acid | 3,0-3,5 | Niacinamide (konsentrasi tinggi) | Pergeseran buffer, potensi transamidasi saat dipanaskan |
| Sodium Ascorbyl Phosphate | 6,0-7,0 | Eksfoliator asam | Hidrolisis gugus fosfat, hilangnya aktivitas |
| Benzoyl Peroxide | 4,5-5,5 | Retinol, vitamin C | Degradasi oksidatif kedua pasangan |
Bagaimana AI memodelkan batasan-batasan ini
Model generatif tidak "mengarang" formula secara bebas — ia bekerja dalam ruang constrained optimization, di mana setiap bahan aktif dideskripsikan bukan hanya dari persentase penggunaannya, tetapi juga dari vektor parameter fisikokimia: rentang pH stabil, suhu dekomposisi, potensial redoks, pasangan incompatibility yang sudah diketahui dari literatur dan basis data paten. Secara praktis ini diimplementasikan sebagai sistem fungsi penalti (penalty function): jika algoritma mencoba menggabungkan retinol dan AHA di atas ambang konsentrasi tertentu, "skor formula" total turun, dan model mencari kombinasi alternatif — misalnya retinol terenkapsulasi atau PHA sebagai pengganti asam glikolat, yang mekanisme iritasinya lebih lembut.
Itulah sebabnya ruang solusi yang dilihat AI jauh lebih sempit dari yang terlihat sekilas: dari ribuan kombinasi bahan aktif secara teoretis, biasanya tidak lebih dari 15-20% yang tetap kompatibel secara kimia setelah memperhitungkan pH, suhu, dan stabilitas oksidatif. Selengkapnya dibahas di artikel tentang stabilitas formula kosmetik.
Arsitektur sistem rekomendasi: dari data pengguna hingga formula jadi
Di balik layar layanan "AI memilihkan krim untukmu" bukanlah satu model tunggal, melainkan pipeline dari beberapa tahap pemrosesan data. Setiap tahap menyelesaikan tugas sempitnya masing-masing, dan hanya rangkaian berurutan dari semua tahap itu yang mengubah input yang terpisah-pisah — foto, kuesioner, keluhan — menjadi daftar bahan aktif spesifik lengkap dengan persentasenya. Mari bedah pipeline ini per tahap.
Lapisan input: apa yang diterima model
Sistem rekomendasi bekerja dengan tiga jenis data, yang digabungkan menjadi satu vektor fitur sebelum dimasukkan ke model:
| Sumber data | Apa yang diekstrak | Format untuk model |
|---|---|---|
| Kuesioner pengguna | tipe kulit (laporan mandiri), keluhan, iklim, status hormonal, rutinitas perawatan saat ini | fitur kategoris dan biner |
| Foto wajah | tekstur, pori, kemerahan, pigmentasi, kerusakan UV (dengan pencitraan multispektral) | embedding dari jaringan konvolusional (biasanya 128-512 fitur) |
| Tujuan target | "meredakan peradangan," "meratakan warna kulit," "anti-aging," "memperbaiki barrier" | vektor tujuan one-hot |
Nuansa penting: data kuesioner dan embedding foto berada pada skala numerik yang berbeda, sehingga sebelum digabungkan diterapkan normalisasi (biasanya z-score atau min-max) — kalau tidak, satu sumber data akan mendominasi yang lain hanya karena rentang nilainya, bukan karena signifikansi sesungguhnya.
Blok model pertama: klasifikasi profil
Pada tahap pertama diselesaikan tugas klasifikasi multi-kelas atau multi-label: sistem tidak menempatkan kulit pengguna ke dalam satu tipe saja (ini adalah penyederhanaan dari kuesioner skincare era 1990-an), melainkan ke dalam kombinasi kondisi — misalnya "zona T seboroik + dehidrasi di area perifer + pigmentasi bekas jerawat." Untuk ini sering digunakan gradient boosting (XGBoost, CatBoost) pada fitur tabular, atau jaringan fully connected kecil jika inputnya berupa embedding gabungan foto dan kuesioner. Akurasi klasifikasi semacam ini pada pilot yang dipublikasikan berkisar 78-89% saat dicocokkan dengan penilaian dermatokosmetolog (menurut Kim et al., 2022) — lebih tinggi dari self-diagnosis lewat kuesioner, tapi lebih rendah dari pemeriksaan profesional di bawah lampu Wood.
Blok kedua: sistem rekomendasi untuk pemilihan bahan aktif
Setelah klasifikasi profil, model kedua bekerja — sistem rekomendasi yang sesungguhnya, yang bekerja dengan logika mirip rekomendasi produk di e-commerce, tapi dengan batasan kimia yang ketat. Di sini digunakan dua pendekatan, sering dalam bentuk hybrid:
- Content-based filtering — mencocokkan profil kulit dengan basis pengetahuan tentang bahan aktif: setiap bahan sudah ditandai sebelumnya dengan kondisi target, mekanisme kerja, rentang konsentrasi efektif, dan ketidakcocokan yang diketahui.
- Collaborative filtering — pelatihan berdasarkan data historis reaksi pengguna serupa terhadap formula serupa (hanya efektif dengan basis ulasan dan pembelian ulang yang cukup besar — puluhan ribu profil).
Komponen content-based menjawab "apa yang secara teori cocok," collaborative menjawab "apa yang benar-benar berhasil pada orang serupa." Tanpa yang pertama, sistem akan merekomendasikan kombinasi yang tidak aman; tanpa yang kedua, sistem kehilangan sensitivitas terhadap pola respons kulit nyata yang tidak selalu sesuai teori.
Lapisan batasan: mengapa model tidak bisa sekadar memaksimalkan efikasi
Daftar bahan aktif akhir tidak dipilih semata-mata dari pertimbangan "apa yang memberi efek maksimal" — di belakang model rekomendasi ada lapisan aturan (rule-based constraint layer) yang menyaring kombinasi berdasarkan kompatibilitas kimia, total keasaman formula, dan konsentrasi maksimal yang diizinkan untuk bahan aktif yang mengiritasi pada tingkat sensitivitas tertentu. Lapisan inilah yang mencegah sistem menetapkan Niacinamide 10% dan dosis tinggi asam murni secara bersamaan pada kulit yang menunjukkan tanda barrier terganggu.
Lapisan output: apa yang dilihat pengguna
Hasil akhir pipeline bukan deskripsi teks, melainkan daftar terstruktur lengkap dengan persentase dan urutan pemakaian:
| Bahan aktif | Konsentrasi | Peran dalam formula |
|---|---|---|
| Niacinamide | 4% | memperkuat barrier, mengatur sebum |
| Sodium Hyaluronate | 1% | hidrasi, menghaluskan permukaan |
| Bakuchiol | 0,5% | efek anti-aging tanpa iritasi ala retinoid |
Tingkat detail seperti ini adalah konsekuensi langsung dari arsitekturnya: sistem tidak "menebak produk," melainkan menyusun formula dari keputusan-keputusan atomik, yang masing-masing sudah melewati klasifikasi, rekomendasi, dan filter kompatibilitas. Selengkapnya tentang bagaimana persentase ini berhubungan dengan dosis penggunaan laboratorium yang sesungguhnya dibahas di artikel tentang dosis penggunaan bahan aktif.
Tipe kulit di mata algoritma: berminyak, kering, kombinasi — dan apa yang dilihat model
Ketika pengguna menandai "kulit saya berminyak" di kuesioner, ia sedang mendeskripsikan sensasi subjektif — kilap di siang hari, pori tersumbat, foundation "luntur" di sore hari. Algoritma bekerja dengan lapisan realitas yang berbeda: ia mengoperasikan parameter fisiologis terukur yang tidak bergantung pada mood, cuaca di luar, atau berapa banyak kopi yang diminum pagi itu. Kesenjangan antara dua gambaran realitas ini adalah alasan mengapa klasifikasi tipe kulit berbasis jaringan saraf tiruan secara konsisten lebih akurat daripada self-report.
Tiga penanda yang dilihat model
Mayoritas klasifikator kulit berbasis algoritma dibangun di atas tiga variabel fisiologis yang sudah diukur secara instrumental oleh dermatolog sejak tahun 1980-an, dan yang kini bisa diperkirakan oleh jaringan saraf tiruan dari foto dan tanda tidak langsung:
- Laju sebum (sebum rate) — kecepatan dan volume produksi sebum oleh sebosit. Diukur secara klinis dengan sebometer (dalam μg/cm²); dari foto, algoritma memperkirakannya secara tidak langsung — melalui pola kilau specular di zona T, ukuran dan kepadatan pori yang terlihat, tekstur piksel lokal di area hidung dan dahi.
- Kehilangan air transepidermal, TEWL — kecepatan penguapan air melalui stratum korneum, indikator kunci integritas barrier lipid. TEWL tinggi menandakan kekeringan dan reaktivitas kulit yang meningkat, bahkan jika secara visual kulit terlihat normal. Dari foto, ini terbaca lewat mikrotekstur: pengelupasan, permukaan tidak rata, area dengan permukaan matte dan "kencang".
- Elastisitas dan kekencangan — kemampuan kulit kembali ke posisi semula setelah deformasi mekanis, terkait kondisi matriks kolagen dan elastin dermis. Diukur secara instrumental dengan cutometer; algoritma memperkirakannya dari kerutan, mikrorelief, dan kekenduran kontur dari waktu ke waktu (jika tersedia rangkaian foto atau video).
Kombinasi ketiga parameter ini menghasilkan bukan satu label "berminyak/kering/kombinasi," melainkan vektor nilai — misalnya laju sebum 68% (tinggi), TEWL 12 g/m²/jam (normalnya 4-10 g/m²/jam), elastisitas 0,75 (menurun). Klasifikasi dibangun di atas vektor ini, bukan berdasarkan kesan visual "terlihat seperti kulit berminyak."
Mengapa penilaian sendiri secara sistematis keliru
Kesenjangan antara apa yang orang pikirkan tentang kulitnya sendiri dan apa yang ditunjukkan alat ukur adalah fakta yang sudah terdokumentasi. Menurut Youn et al. (2002), kecocokan self-diagnosis tipe kulit dengan pengukuran sebometer objektif kurang dari 60% kasus; kebingungan terbesar terjadi antara "kombinasi" dan "berminyak," serta antara "normal" dan "kering." Penyebabnya bisa diprediksi:
- Produksi sebum berfluktuasi 20-40% sepanjang hari, sehingga penilaian "kira-kira" di pagi dan sore hari memberikan jawaban berbeda.
- Kekeringan sering disalahartikan sebagai dehidrasi (kekurangan kelembapan di stratum korneum, bukan lipid) — ini dua mekanisme berbeda yang memerlukan bahan aktif berbeda pula.
- Kulit kombinasi adalah tipe yang secara statistik paling sering salah didiagnosis: orang cenderung melebih-lebihkan minyak di zona T atau tidak menyadari kekeringan di pipi karena fokus perhatian tertuju pada masalah yang terlihat (pori, kilap).
- Musim dan makeup yang "menyamarkan": foundation atau primer matte secara visual menormalkan kulit sesaat, mendistorsi persepsi terhadap kondisi dasarnya.
Kulit kombinasi: mengapa ini bukan "dua tipe dalam satu"
Algoritma memperlakukan kulit kombinasi bukan sebagai campuran kulit berminyak dan kering, melainkan sebagai heterogenitas zonal dari set parameter yang sama. Model membagi wajah menjadi segmen (zona T, pipi, area periorbital) dan menghitung vektor sebum/TEWL/elastisitas tersendiri untuk masing-masing. Profil akhirnya bukan nilai rata-rata, melainkan peta perbedaan: zona T bisa menunjukkan laju sebum 70% dengan TEWL 6 g/m²/jam, sementara pipi menunjukkan laju sebum 25% dengan TEWL 14 g/m²/jam. Ini krusial untuk formulasi: serum dengan konsentrasi Niacinamide tunggal untuk seluruh wajah bekerja lebih buruk dibanding distribusi bahan aktif per zona, yang dibahas lebih rinci di artikel tentang kompatibilitas bahan (/blog/himiya-sovmestimosti-aktivov).
Kesimpulan praktis untuk formulasi: akurasi klasifikasi tipe kulit secara langsung menentukan rentang konsentrasi bahan aktif yang diizinkan. Kesalahan 15-20% dalam estimasi TEWL bisa menyebabkan formula dengan Salicylic Acid 2% direkomendasikan untuk kulit yang barriernya sudah terganggu — dan alih-alih membersihkan pori, pengguna malah mendapatkan iritasi dan pengelupasan yang lebih parah.
Tujuan formula: bagaimana AI membedakan "anti-jerawat" dan "untuk kulit cerah"
Tipe kulit menetapkan batasan dasar formula, tapi tujuan target-lah yang menentukan bahan aktif mana yang masuk ke dalam komposisi dengan prioritas utama. Bagi algoritma, ini bukan label teks "jerawat" atau "cerah," melainkan vektor endpoint klinis — sekumpulan parameter terukur yang menjadi bukti efikasi bahan dalam studi. Model mencocokkan permintaan pengguna dengan vektor ini, bukan dengan nama masalahnya.
Dari permintaan ke vektor klinis
Saat pengguna menulis "saya ingin menghilangkan breakout," modul NLP sistem menerjemahkan permintaan tersebut menjadi kombinasi fitur: hiperkeratinisasi folikuler, kolonisasi Cutibacterium acnes, peradangan lokal, produksi sebum berlebih. Permintaan "untuk kulit cerah" diuraikan secara berbeda: stratum korneum yang tidak merata, pergantian sel yang melambat, kekusaman mikro akibat glikasi kolagen. Perbedaan dalam dekomposisi permintaan inilah level pertama yang membedakan tujuan.
Selanjutnya, setiap fitur mencari kecocokan di basis data bahan aktif, tempat setiap bahan ditandai bukan berdasarkan klaim pemasaran, melainkan mekanisme kerja yang dikonfirmasi dalam studi:
| Tujuan | Mekanisme kunci | Bahan aktif tipikal | Rentang konsentrasi |
|---|---|---|---|
| Anti-jerawat | Regulasi sebum + aksi antimikroba | Salicylic Acid, Azelaic Acid, Niacinamide | 0,5-2% / 10-20% / 4-5% |
| Untuk kulit cerah | Percepatan deskuamasi + perlindungan antioksidan | Glycolic Acid, Sodium Ascorbyl Phosphate, Tranexamic Acid | 5-10% / 3-5% / 2-3% |
| Anti-aging | Stimulasi sintesis kolagen | Retinol, kompleks peptida, Bakuchiol | 0,3-1% / 2-5% / 0,5-2% |
| Perbaikan barrier | Pengisian ulang lipid | Ceramide NP, Cholesterol, Squalane | 1-3% / 0,5-1% / hingga 10% |
Penting dicatat, bahan yang sama bisa masuk ke beberapa tujuan sekaligus dengan fungsi bobot berbeda. Niacinamide bekerja pada jerawat (regulasi sebum), pigmentasi (menghambat transfer melanosom), dan barrier (menstimulasi sintesis ceramide) sekaligus — menurut Bissett et al. (2004) dan studi-studi selanjutnya. Algoritma tidak memilih bahan "untuk satu tujuan," melainkan menjumlahkan kontribusi mekanismenya terhadap semua vektor target aktif pengguna secara bersamaan.
Bagaimana data klinis mengkalibrasi bobot
Setiap hubungan "bahan aktif → efek" di basis data memiliki bukan nilai biner (bekerja/tidak bekerja), melainkan koefisien efikasi numerik yang diperoleh dari meta-analisis. Misalnya, untuk Azelaic Acid pada konsentrasi 15%, penurunan lesi jerawat inflamasi setelah 12 minggu tercatat sekitar 40-50% (menurut Sieber & Hegel, 2014), sementara Salicylic Acid 2% memberikan efek yang lebih moderat namun lebih cepat terhadap komedo. Model memperhitungkan bukan hanya "bekerja atau tidak," tapi juga kecepatan respons, yang krusial saat menyusun ekspektasi pengguna.
Sumber kalibrasi kedua adalah umpan balik agregat. Ketika ribuan pengguna dengan profil kulit digital serupa mencatat perubahan parameter spesifik (kilap berminyak, jumlah papula, warna kulit) setelah 4, 8, dan 12 minggu pemakaian, sistem menghitung ulang bobot rekomendasi. Ini bekerja seperti pembaruan Bayesian: data klinis menetapkan distribusi efikasi prior, sementara umpan balik perilaku memberikan koreksi posterior untuk populasi pengguna nyata — bukan hanya untuk kondisi studi laboratorium.
Konflik tujuan dalam satu formula
Kompleksitas muncul ketika pengguna merumuskan dua tujuan sekaligus — "menghilangkan jerawat dan menambah kecerahan kulit." Vektornya sebagian tumpang tindih (deskuamasi dibutuhkan kedua tujuan), tapi sebagian berkonflik: regulasi sebum yang agresif bisa memperparah kekeringan dan kekusaman yang justru ingin diperbaiki pengguna. Algoritma menyelesaikan ini melalui prioritisasi berdasarkan tingkat keparahan kondisi — peradangan aktif mendapat bobot lebih tinggi dibanding tujuan estetika, sementara bahan pendukung (misalnya antioksidan) dimasukkan pada konsentrasi pendukung, bukan terapeutik. Selengkapnya tentang bagaimana sistem menyelesaikan tumpang tindih ini pada level kompatibilitas bahan dibahas di artikel tentang kimia kompatibilitas bahan aktif.
Batasan dan risiko: kapan algoritma keliru
Sistem rekomendasi hanya sebaik data yang digunakan untuk melatihnya. Aturan ini terdengar klise, tapi justru inilah yang menjelaskan sebagian besar kesalahan sistematis dalam pemilihan bahan aktif berbasis AI. Model tidak "memahami" kulit — ia menemukan pola statistik dalam sampel, dan jika sampelnya bias, hasilnya pun bias.
Bias berdasarkan fototipe dan etnisitas
Sebagian besar dataset dermatologis terbuka yang digunakan untuk melatih model computer vision analisis kulit secara historis didominasi oleh gambar fototipe terang (I-III pada skala Fitzpatrick). Hiperpigmentasi pascainflamasi, yang umum pada fototipe IV-VI, terdeteksi lebih buruk oleh model semacam ini: algoritma menyamakannya dengan lesi inflamasi atau bahkan tidak mencatatnya sebagai masalah tersendiri. Menurut Adamson dan Smith (2018), kurangnya keragaman dalam gambar dermatologis secara sistematis menurunkan akurasi diagnosis khususnya pada kulit sawo matang dan gelap. Untuk pemilihan bahan aktif, ini berarti risiko: sistem mungkin tidak merekomendasikan bahan pencerah seperti Tranexamic Acid atau Alpha Arbutin di tempat yang sebenarnya membutuhkannya, karena tidak mengenali pola pigmentasi tersebut sebagai patologis.
Overfitting pada data pemasaran
Sebagian layanan rekomendasi dilatih bukan berdasarkan data klinis, melainkan teks deskripsi produk, ulasan, dan materi pemasaran merek. Dalam sampel semacam ini, kata-kata seperti "melembapkan," "menyamarkan pori," "meratakan warna kulit" muncul jauh lebih sering dibanding pengukuran TEWL (kehilangan air transepidermal) atau sebumetri yang sesungguhnya. Model mulai overfitting pada retorika penjual, bukan pada biokimia bahan. Hasilnya — sistem dengan percaya diri merekomendasikan komposisi dengan Niacinamide 2% "untuk menyamarkan pori," padahal efek yang secara klinis terlihat pada sekresi sebum baru tercatat mulai konsentrasi 4-5% (menurut Draelos et al., 2006), dan kemasannya bahkan tidak mencantumkan konsentrasinya.
Tidak adanya riwayat medis
Tidak ada satu pun sistem analisis kulit foto konsumen massal yang memiliki akses ke riwayat reaksi alergi, konsumsi obat sistemik (isotretinoin, antikoagulan, terapi hormon), atau dermatosis penyerta — rosasea, dermatitis perioral, atopi. Algoritma melihat tekstur dan warna, tapi tidak "tahu" bahwa pengguna sedang mengonsumsi warfarin, atau bahwa Retinol konsentrasi tinggi dikombinasikan dengan eksfoliator asam akan meningkatkan risiko iritasi di atas jaringan pembuluh darah tipis. Tidak ada analisis visual yang menggantikan patch test dan penggalian riwayat medis.
| Jenis batasan | Mekanisme kesalahan | Konsekuensi bagi formula |
|---|---|---|
| Bias data fototipe | Kurangnya gambar kulit gelap dalam sampel pelatihan | PIH terlewat, pemilihan bahan pencerah yang salah |
| Overfitting pada pemasaran | Pelatihan berdasarkan teks iklan alih-alih data klinis | Konsentrasi efektif dinilai terlalu rendah/tinggi |
| Tidak ada riwayat medis | Tidak ada akses ke alergi dan obat-obatan | Risiko interaksi dengan obat sistemik |
| Tidak ada validasi dermatologis | Model belum diuji pada pasien nyata dengan patologi | Keyakinan palsu terhadap keamanan komposisi |
Mengapa validasi dermatologis diperlukan
Model yang menunjukkan akurasi tinggi pada dataset uji internal tidak otomatis valid secara klinis. Kesenjangan antara accuracy pada dataset dan nilai diagnostik nyata adalah masalah standar ML di dunia medis, dijelaskan misalnya dalam Kim et al. (2019) terkait CNN dermoskopik: model yang dilatih pada satu populasi kehilangan hingga 20-30% akurasi saat dipindahkan ke kelompok etnis atau usia lain tanpa kalibrasi tambahan. Untuk sistem rekomendasi kosmetik, ini berarti klaim "akurasi 90%" hampir selalu merujuk pada sampel yang sempit dan tidak menjamin hasil yang sama pada wajah pengguna tertentu.
Kesimpulan praktis bagi siapa pun yang merancang atau menggunakan sistem semacam ini: rekomendasi AI adalah draft formula yang membutuhkan verifikasi pada kulit nyata, patch test, dan — pada kasus yang meragukan — konsultasi dermatolog. Otomasi mempercepat pemilihan bahan aktif, tapi tidak menghapus tanggung jawab atas keputusan akhir dari tangan orang yang menyusun formulanya.
Masa depan personalisasi: dari rekomendasi menuju produksi sesuai pesanan
Semua yang dibahas di atas — pengenalan kulit, pengecekan kompatibilitas bahan aktif, pencocokan tujuan formula — masih beroperasi dalam batas assortment yang sudah ada: algoritma memilih produk jadi atau paling banter mengusulkan "campurkan serum A dengan krim B." Langkah berikutnya bagi industri ini adalah menghilangkan perantara berupa lini produk jadi. Alih-alih rekomendasi, sistem diberi wewenang untuk menghasilkan komposisi dari nol sesuai profil kulit digital tertentu, lalu memproduksi tepat formula itu dalam satu unit saja.
Ini adalah arsitektur bisnis yang sama sekali berbeda: bukan "10.000 toples identik," melainkan micro-batch untuk satu orang — batch 1 hingga 50 ml, disusun sesuai parameter yang tidak dimiliki klien lain mana pun. Secara teknis, ini menjadi mungkin berkat tiga arah yang saling bertemu: model generatif yang mampu mengusulkan bukan produk jadi, melainkan vektor konsentrasi; lini produksi modular dengan dispenser yang mencampur bahan aktif secara real-time; dan pencetakan 3D bentuk kosmetik, tempat printer menjadi tahap perakitan akhir.
Pemilihan generatif alih-alih klasifikasi
Sistem rekomendasi saat ini menyelesaikan tugas klasifikasi: "profil kulit ini cocok dengan produk X dari katalog." Model generatif menyelesaikan tugas optimisasi: "kombinasi apa dari 15-20 bahan aktif yang diizinkan, dalam proporsi berapa, memberikan efek yang diharapkan maksimal dengan risiko ketidakcocokan nol." Inputnya sama — profil kulit digital (tekstur, sebumetri, hidrasi, riwayat respons) — tapi outputnya bukan nama produk, melainkan vektor numerik: misalnya Niacinamide 4%, Sodium Hyaluronate 1%, Panthenol 3%, basis hingga 100%. Pendekatan ini sedang diuji dalam pilot laboratorium di beberapa produsen besar (menurut Guo et al., 2022, model generatif berbasis basis data formulasi memprediksi kombinasi bahan aktif yang stabil dengan akurasi yang sebanding dengan solusi formulator manusia pada kategori terbatas — emulsi pelembap dan serum antioksidan).
Pencetakan 3D: dari konsep ke rak toko
Pencetakan 3D kosmetik bukan lagi metafora futuristik — printer ekstrusi untuk tekstur semi-solid (balm, masker, stik) menangani viskositas 5.000-50.000 mPa·s dan memungkinkan berbagai bahan aktif diaplikasikan berlapis dalam satu produk: misalnya zona dengan konsentrasi Salicylic Acid yang lebih tinggi di area zona T pada masker, dan zona dengan Ceramide NP di bagian tepi wajah. Rentang suhu pencetakan dibatasi oleh sensitivitas termal bahan aktif: mayoritas peptida dan vitamin C dalam bentuk Ascorbic Acid tidak tahan ekstrusi di atas 40°C, sehingga produsen beralih ke turunan yang lebih stabil — Sodium Ascorbyl Phosphate atau Ascorbyl Glucoside, yang stabil hingga 60-70°C.
| Parameter | Produksi massal | Micro-batch personal |
|---|---|---|
| Volume batch | 1.000-50.000 L | 1-50 ml |
| Waktu dari pemesanan hingga siap | berminggu-minggu (logistik + penjualan dari gudang) | menit-jam (perakitan lokal) |
| Sumber resep | formula tetap dari divisi R&D | model generatif + profil pengguna |
| Kontrol stabilitas | terpusat, pada tahap produksi | terdistribusi, membutuhkan pemantauan AI lokal |
Apa yang masih perlu matang di bidang bioteknologi
Personalisasi generatif terhambat bukan terutama oleh kapasitas model, melainkan oleh keterbatasan kimia dan bioteknologi. Tiga titik sempit:
- Stabilitas pada volume kecil. Micro-batch tanpa sistem pengawet yang dirancang untuk skala industri akan lebih cepat rusak — dibutuhkan protokol pemilihan pengawet baru (misalnya kombinasi Phenoxyethanol dengan Ethylhexylglycerin) untuk volume 10-50 ml dengan masa pakai 2-4 minggu.
- Biosensor untuk data input. Akurasi formula generatif secara langsung bergantung pada akurasi profil kulit: pengembangan biosensor yang bisa dikenakan (pengukuran TEWL, pH, mikrobioma secara real-time) harus mengejar ambisi algoritma.
- Kerangka regulasi. Perundang-undangan kosmetik (di UE — Regulation 1223/2009) ditulis untuk produksi serial dengan komposisi tetap; untuk formula yang berubah pada setiap pelanggan, belum ada protokol sertifikasi keamanan yang jelas untuk setiap batch unik.
Horizon realistis untuk peralihan massal dari rekomendasi ke produksi sesuai pesanan adalah 5-8 tahun, dan pihak pertama yang mengadopsinya bukanlah merek mass-market, melainkan klinik dermatologi niche dan laboratorium premium, tempat biaya satu micro-batch sepadan dengan presisi medisnya. Bagi spesialis yang saat ini belajar memformulasikan secara manual, tren ini bukan ancaman — melainkan pergeseran peran: dari menciptakan satu formula untuk ribuan orang menjadi menyusun aturan yang dipakai algoritma untuk menciptakan ribuan formula bagi satu orang.
Kesimpulan: percaya pada algoritma atau percaya pada kulit sendiri
Selama sembilan bagian, kita sudah menelusuri perjalanan dari foto kulit hingga lini produksi yang mampu menyusun serum berdasarkan set data spesifik. Tapi pertanyaan akhirnya selalu sama: siapa yang memutuskan apa yang akan berakhir di wajah — model atau manusia. Jawabannya tidak biner. Algoritma tepat pada hal yang terukur: konsentrasi Niacinamide, kompatibilitas Retinol dan AHA, jendela pH untuk stabilitas Ascorbic Acid. Ia buta pada hal yang membutuhkan konteks — latar belakang hormonal, kehamilan, konsumsi isotretinoin, hubungan psikologis seseorang dengan tekstur dan aroma produk.
Apa yang dilakukan algoritma lebih baik daripada manusia
Jaringan saraf tiruan tidak pernah lelah mencocokkan puluhan parameter sekaligus dan tidak rentan terhadap bias kognitif seperti "bahan ini lagi tren, berarti bagus." Ia menyimpan seluruh tabel kompatibilitas bahan aktif dalam memori dan menghitung ulang formula dalam hitungan detik jika bahkan satu parameter input berubah — kelembapan wilayah, musim, hasil sebumetri baru. Secara fisik, sulit bagi manusia untuk mengingat 40+ variabel kompatibilitas INCI secara bersamaan pada setiap konsultasi.
| Tugas | Lebih baik ditangani oleh | Alasannya |
|---|---|---|
| Menghitung % bahan aktif dan kompatibilitas pH | Algoritma | Matematika yang ketat, tanpa kelelahan perhatian |
| Menilai penanda visual kulit dari foto | Algoritma (dengan catatan) | Standardisasi, tanpa subjektivitas pencahayaan |
| Mendiagnosis dermatosis yang butuh biopsi/riwayat medis | Dermatolog | Membutuhkan data yang tidak tersedia bagi model: riwayat penyakit, palpasi, perkembangan kondisi |
| Menilai sensori dan kenyamanan subjektif formula | Kosmetolog + pengguna | Estetika dan sensasi taktil tidak bisa diformalkan ke dalam dataset |
| Keputusan akhir soal keamanan saat kehamilan, konsumsi obat | Dokter | Tanggung jawab hukum dan medis |
Model praktis: algoritma sebagai draft, manusia sebagai editor
Skema kerja yang muncul dari semua materi yang sudah dibahas adalah sebagai berikut: AI membentuk hipotesis komposisi berdasarkan profil kulit digital dan tujuan yang dinyatakan, lalu spesialis — kosmetolog, dermatolog, atau pengguna yang cukup terinformasi — melakukan koreksi yang tidak bisa diperhitungkan model. Ini tidak berbeda dengan cara kerja GPS navigator: ia mengusulkan rute berdasarkan data peta dan lalu lintas, tapi pengemudi melihat jalan tertutup yang tidak ada di basis data dan mengoreksi rute secara manual.
- Langkah 1. Algoritma menganalisis foto dan kuesioner, menghasilkan 2-3 opsi formula lengkap dengan bahan aktif kunci dan dosis penggunaannya.
- Langkah 2. Kosmetolog atau pengguna memeriksa opsi tersebut untuk ketidakcocokan yang jelas dengan rutinitas saat ini — misalnya Tretinoin resep yang sudah digunakan, yang mungkin tidak diketahui algoritma.
- Langkah 3. Patch test dilakukan di bagian dalam lengan bawah selama 48 jam, terlepas dari seberapa "aman" komposisi tersebut menurut algoritma.
- Langkah 4. Respons kulit dicatat dan dikembalikan ke sistem sebagai datapoint baru untuk iterasi rekomendasi berikutnya.
Apa artinya ini bagi mereka yang memformulasikan dan menjual kosmetik
Bagi spesialis yang mengembangkan komposisi, pemilihan bahan aktif berbasis AI bukan ancaman bagi profesi, melainkan perluasan perangkat kerja — sebanding dengan peralihan dari perhitungan emulsi manual ke pemodelan stabilitas berbasis software. Memahami bagaimana model menginterpretasikan data kulit dan mengapa ia kadang keliru (lihat bagian tentang batasan) menjadi bagian dari literasi dasar seorang formulator — sama seperti memahami kimia emulgator atau rezim suhu Fase A dan B.
Posisi akhir yang bertahan baik dari sisi data maupun praktik: algoritma bisa dipercaya untuk perhitungan kompatibilitas dan pemilihan konsentrasi awal, tapi arbiter akhir keamanan dan kenyamanan tetaplah manusia — baik spesialis dengan latar belakang medis maupun pengguna itu sendiri, yang dilengkapi pemahaman tentang kulitnya sendiri dan prinsip dasar kimia bahan aktif. Teknologi mempersingkat proses tebak-tebakan, tapi tidak menghapus kebutuhan untuk mendengarkan respons kulit di sini dan sekarang — ia berubah lebih cepat daripada model mana pun bisa melatih ulang dirinya.
Memilih bahan aktif hanyalah permulaan — selanjutnya diperlukan verifikasi kompatibilitas dan konsentrasi kerja. AI Chemist di Walker Formulation Academy Club melakukan ini berdasarkan basis data INCI/CosIng yang terverifikasi, bukan tebakan, dan menandai di mana bahan aktif saling berkonflik. Jika Anda ingin menguasai pemilihan bahan aktif secara sistematis, klub ini menyediakan program dengan instruktur langsung.