Halo, saya Oksana Volker, dan mulai hari ini kita akan menjalani seri baru tentang cara membedah komposisi INCI kompetitor dengan bantuan AI, langkah demi langkah dari teori dasar sampai eksekusi praktis. Sebelum menyentuh algoritma, kita perlu paham dulu kenapa analisis semacam ini penting dan apa sebenarnya yang dibaca AI ketika melihat daftar INCI.
Mengapa Perlu Menganalisis Komposisi INCI Kompetitor, dan Bagaimana AI Membantu
Setiap botol di rak mass-market atau di butik niche bukan sekadar marketing dan kemasan, melainkan formula terenkripsi yang tersedia secara terbuka bagi siapa saja dalam bentuk daftar INCI (International Nomenclature of Cosmetic Ingredients). Daftar pada label inilah satu-satunya sumber legal yang memungkinkan seorang formulator mengekstrak struktur formula pihak lain tanpa akses ke dokumentasi laboratorium. Membedah komposisi kompetitor sudah lama bukan lagi kegiatan niche milik analis paten — ini adalah tugas rutin brand manager, spesialis R&D, dan formulator kosmetik yang ingin memahami pasar lebih cepat daripada berminggu-minggu kerja manual.
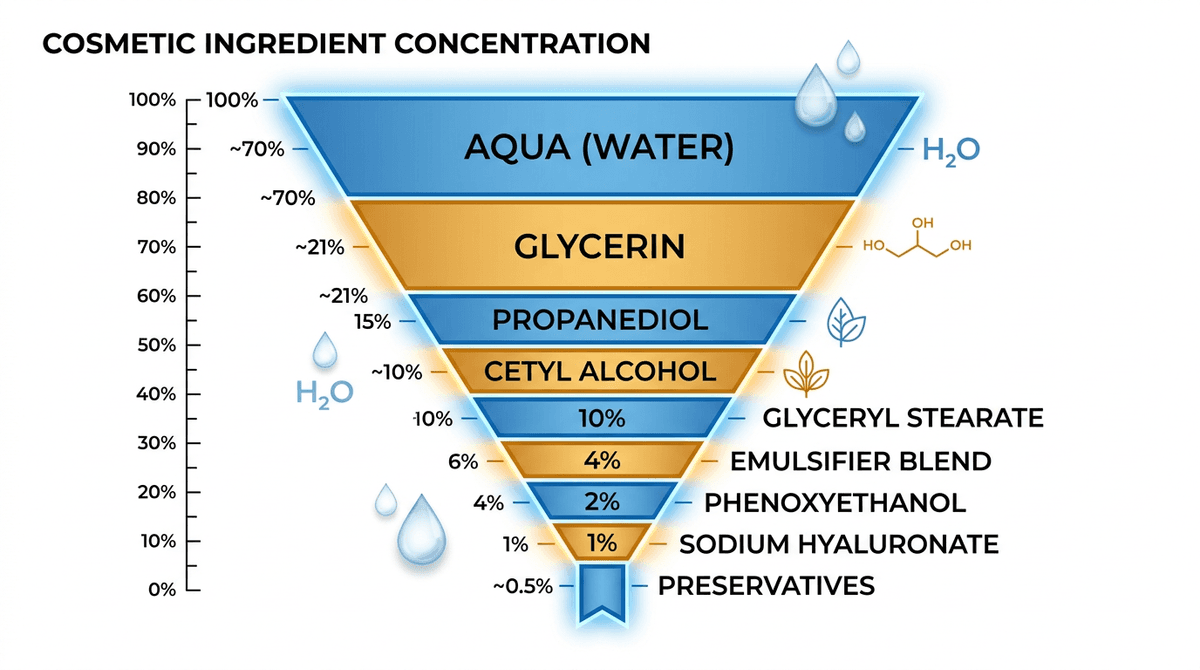
Daftar INCI tunduk pada aturan ketat: bahan dicantumkan berdasarkan urutan konsentrasi menurun, sementara komponen dengan kadar di bawah 1% boleh dicantumkan dalam urutan bebas. Batasan ini sekaligus menjadi petunjuk dan jebakan — ia memberi kerangka formula, tapi bukan angka pasti. Dari sinilah tantangan utama analisis manual: formulator melihat urutan, tetapi harus merekonstruksi rentang konsentrasi yang mungkin, berdasarkan batas regulasi, peran fungsional bahan, dan praktik formulasi yang umum.
Kebutuhan Apa Saja yang Dipenuhi oleh Analisis Komposisi Kompetitor
Mempelajari formula pihak lain jarang sekadar didorong rasa ingin tahu. Dalam praktiknya, ada beberapa kebutuhan bisnis dan R&D yang konkret di baliknya:
- Benchmarking formula — membandingkan resep Anda dengan produk-produk terlaris di kategori tersebut dari segi jenis basis, bahan aktif, dan komponen pendukung.
- Mencari titik lemah produk — mengidentifikasi pengawet yang sudah usang, kandungan silikon berlebihan, atau bahan aktif yang diklaim di kemasan tapi tidak hadir dalam konsentrasi efektif.
- Reverse-engineering tekstur acuan — memahami sistem pengemulsi dan modifier reologi apa yang menciptakan konsistensi khas produk best seller.
- Verifikasi klaim marketing — apakah klaim "mengandung retinol" sesuai dengan posisi aktualnya di daftar bahan, atau hanya dosis simbolis di kisaran 0.01%.
- Perencanaan diferensiasi — mencari celah resep yang belum digarap, ketika seluruh segmen menggunakan kombinasi humektan yang itu-itu saja.
Dulu, kebutuhan-kebutuhan ini dipenuhi secara manual: formulator membuka label, mencocokkan tiap bahan dengan referensi INCI Decoder atau CosIng, memperkirakan golongan fungsionalnya, lalu mencatat hipotesis dalam tabel. Prosesnya memakan waktu setengah jam hingga beberapa jam per produk — dan kualitas hasilnya sangat bergantung pada pengalaman formulator yang bersangkutan.
Peran Analisis AI dalam Membedah Formula
Analisis AI terhadap komposisi bukan pengganti keahlian kimia, tapi ia mempercepat drastis pengolahan data awal. Model bahasa yang dilatih pada basis data regulasi dan terminologi formulasi mampu, hanya dalam hitungan detik:
- Mengenali peran fungsional tiap komponen dalam daftar (pengemulsi, pengawet, humektan, antioksidan, dan seterusnya);
- Mengelompokkan bahan berdasarkan fase emulsi — fase air, fase minyak, fase aktif;
- Memperkirakan rentang konsentrasi yang mungkin berdasarkan posisi dalam daftar dan batas regulasi yang diketahui (berdasarkan riset formulasi yang direproduksi Draelos, 2015, dan tinjauan-tinjauan praktik formulasi berikutnya);
- Mendeteksi kombinasi yang berpotensi bermasalah — misalnya ketidakcocokan pengawet tertentu dengan pH tinggi.
Analisis AI semacam ini terhadap komposisi INCI kompetitor mengubah deretan huruf statis di label menjadi hipotesis resep yang terstruktur: dengan arsitektur formula perkiraan, distribusi per fase, dan dugaan konsentrasi bahan aktif utama. Selanjutnya, hipotesis ini diperiksa dan dikoreksi oleh formulator — AI memberi draf, bukan vonis akhir.
Pada bagian-bagian berikutnya, kita akan membedah bagaimana proses ini bekerja — dari menyiapkan daftar INCI hingga menyusun prompt untuk AI dan menginterpretasikan laporan yang dihasilkan — lalu menjalani seluruh alurnya langkah demi langkah lewat contoh konkret.
Apa Itu INCI dan Mengapa Ini Bukan Sekadar Daftar Bahan
INCI (International Nomenclature of Cosmetic Ingredients) adalah sistem penamaan bahan baku yang seragam, digunakan untuk pelabelan produk kosmetik. Setiap nama dalam nomenklatur ini terikat pada struktur kimia atau sumber botani tertentu dan tidak bergantung pada merek dagang produsen. Artinya, Glycerin di kemasan merek Prancis dan Glycerin di kemasan merek Korea adalah zat yang identik secara molekuler, terlepas dari bagaimana ia disebut dalam materi promosi. Namun justru karena standardisasi nama inilah komposisi berubah menjadi teks tersandi: tanpa memahami aturan urutan dan nilai ambang batas, daftar bahan bisa dibaca keliru — bahkan kadang terbalik sepenuhnya.
Prinsip Konsentrasi Menurun
Aturan utama INCI adalah komponen dicantumkan berdasarkan urutan konsentrasi menurun, tapi hanya sampai titik tertentu. Menurut Cosmetic Regulation (EC) No 1223/2009 Eropa, yang mengatur pelabelan kosmetik di wilayah UE, bahan dengan konsentrasi di atas 1% wajib dicantumkan secara ketat berdasarkan urutan menurun kadar massanya. Artinya, 3–5 posisi pertama dalam daftar hampir selalu merupakan basis formula: air, emolien, pengemulsi, humektan. Jika Aqua berada di posisi pertama dan posisi berikutnya Glycerin, formulator sebenarnya sudah memberi tahu Anda rasio perkiraan antara fase air dan fase gliserin, tanpa satu pun angka di label.
Ambang Batas Tersembunyi: Apa yang Terjadi di Bawah 1%
Setelah konsentrasi komponen turun di bawah 1%, aturan urutan ketat tidak lagi berlaku. Regulasi 1223/2009 mengizinkan produsen mencantumkan bahan-bahan tersebut dalam urutan bebas — ini berlaku untuk pengawet, fragrance, pewarna, dan bahan aktif berdosis rendah (peptida, ekstrak, vitamin). Karena itulah, di ujung daftar sering kali berdampingan kompleks peptida mahal dan pewarna biasa seperti CI 19140 — dari posisinya di INCI, mustahil diketahui mana yang 0.9% dan mana yang 0.01%.
Ini krusial saat menganalisis formula kompetitor: jika alat AI atau analis manusia menganggap "sepertiga bawah" daftar sebagai tidak penting, mudah saja melewatkan bahan aktif yang sengaja diletakkan produsen di bawah ambang 1% agar konsentrasi dan perannya yang sesungguhnya dalam formula tidak terungkap.
Nama Penyamar: Parfum, Aqua, dan Istilah Kelompok
Nomenklatur INCI mengizinkan istilah "payung" yang menyembunyikan puluhan zat kimia di balik satu kata:
- Parfum / Fragrance — bisa mencakup 50–200 komponen aromatik tersendiri, sebagian di antaranya berpotensi alergen, yang baru wajib dicantumkan terpisah jika melewati ambang tertentu (di UE, ada 26 nama alergen yang wajib dilabeli individual di atas konsentrasi 0.001% pada produk leave-on dan 0.01% pada produk rinse-off).
- Aqua / Water — secara formal satu molekul, tapi komposisi fase air yang sesungguhnya pada produk premium sering mencakup air termal, air misel, atau air suling dengan profil mineral berbeda, yang tidak tercermin dalam namanya.
- Istilah kelompok seperti Parfum memungkinkan formula fragrance dilindungi sebagai rahasia dagang — regulasi mengizinkan produsen tidak membuka komposisi persis campuran aroma, dengan alasan melindungi kekayaan intelektual sang perfumer.
Ketidaktransparanan ini bukan celah, melainkan kompromi yang disengaja antara hak konsumen atas informasi dan perlindungan resep. Kerangka regulasinya dijabarkan rinci dalam teks Regulation (EC) No 1223/2009 Parlemen Eropa, sementara sistematisasi aturan nomenklatur dan perkembangan historisnya dibahas dalam literatur regulasi kosmetik (berdasarkan Rathi, 2011; pembahasan serupa mengenai arsitektur nomenklatur INCI disajikan dalam studi Bilal & Iqbal, 2020).
Mengapa Ini Mengubah Cara Menganalisis
Ketika AI mem-parsing komposisi INCI kompetitor, ia harus memperhitungkan bukan hanya urutan kata, tapi juga aturan struktural: di mana batas zona "di atas 1%" berakhir, istilah mana yang menyembunyikan campuran kompleks, dan posisi mana di ujung daftar yang sebenarnya bisa jadi bahan aktif mahal, bukan sekadar "residu sisa". Tanpa konteks ini, AI akan menafsirkan daftar secara linear — seolah posisi #15 pasti kurang penting dibanding posisi #5, padahal untuk formula riil hal ini tidak selalu benar.
Bagaimana AI 'Membaca' Struktur Kimia Komposisi: Mekanisme NLP-Parsing INCI
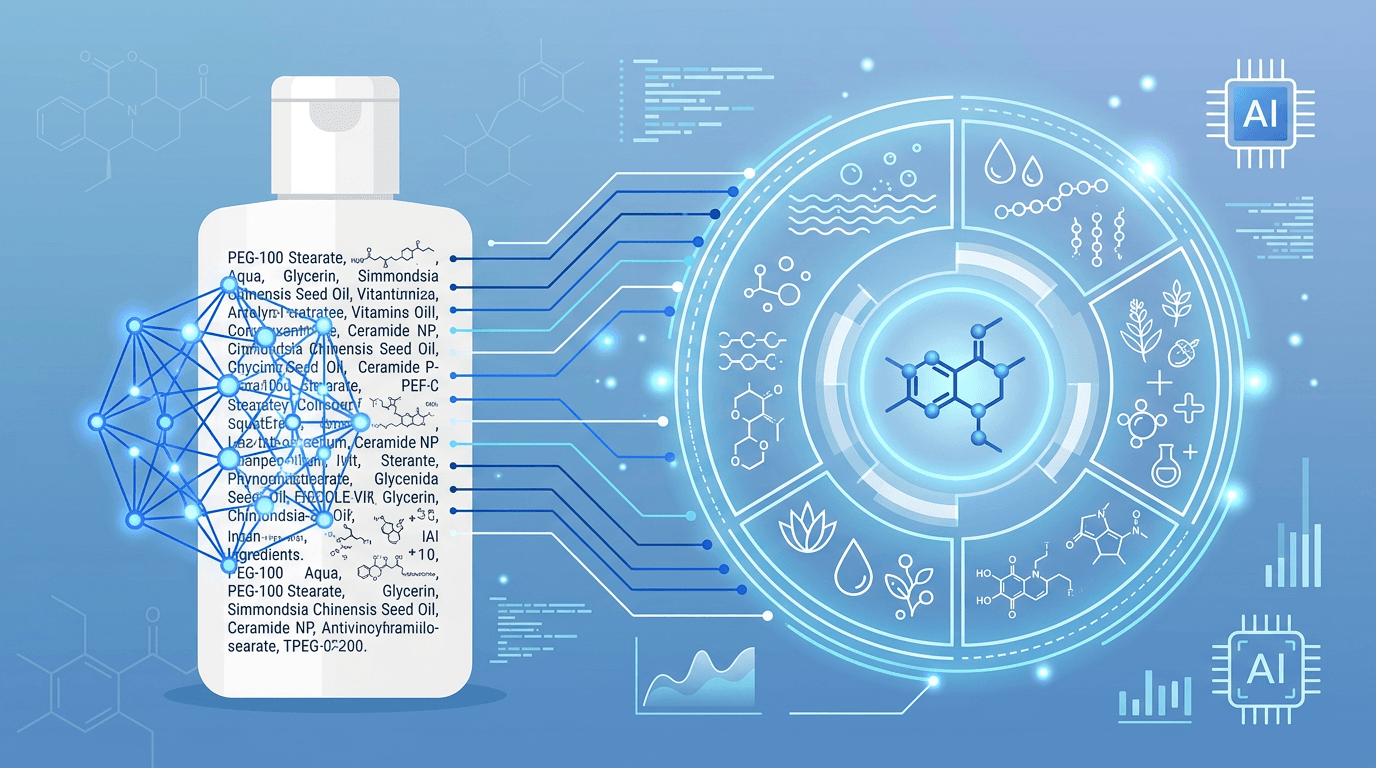
String INCI di label bukanlah teks koheren dengan tata bahasa, melainkan daftar token datar yang dipisah koma, di mana urutan mencerminkan konsentrasi, bukan logika naratif. Bagi model bahasa, ini tugas yang tidak lazim: pipeline NLP standar dilatih pada bahasa alami dengan hubungan sintaksis, sementara komposisi krim lebih mirip katalog nomenklatur, secara struktur lebih dekat ke basis data kimia daripada ke prosa. Karena itu, parsing INCI membutuhkan rantai pemrosesan khusus, bukan chatbot serba guna.
Tokenisasi dan Named Entity Recognition (NER)
Tahap pertama adalah Named Entity Recognition (NER) yang diadaptasi untuk domain kimia. Model memecah string menjadi token-token kandidat dan mengklasifikasikan tiap token sebagai kemungkinan nama bahan, bahkan jika terdiri dari beberapa kata (Sodium Ascorbyl Phosphate adalah satu entitas, bukan tiga). Kesulitannya, nomenklatur INCI memakai nama botani Latin, singkatan dagang, indeks numerik (PEG-100 Stearate), dan konstruksi majemuk dengan tanda hubung serta kurung — tokenizer standar yang dilatih pada korpus berita sering keliru memecah istilah-istilah semacam ini.
Untuk meningkatkan akurasi, digunakan model yang diadaptasi khusus domain seperti BioBERT atau ChemBERTa, yang di-fine-tune pada teks kimia dan biomedis — embedding-nya lebih baik menangkap pola nomenklatur kimia dibanding model serba guna (berdasarkan Beltagy et al., 2019, dalam konteks SciBERT untuk teks ilmiah). Selain itu, digunakan aturan regex untuk mengenali sufiks numerik (-100, -20) dan pola mirip CAS, yang menurunkan frekuensi false positive pada token yang tidak dikenal.
Pencocokan dengan Basis Data: Dari String ke Struktur
Setelah tokenisasi, entitas yang dikenali melewati tahap entity linking — pencocokan dengan basis data acuan. Di sini beberapa sumber digunakan sekaligus:
- CosIng (Cosmetic Ingredient Database) — basis data resmi Uni Eropa yang memuat nama INCI, nomor CAS, golongan fungsional, dan batasan regulasi.
- PubChem — basis data senyawa kimia dengan struktur molekulnya, yang memungkinkan model menghubungkan nama INCI dengan notasi SMILES tertentu dan sifat fisikokimianya.
- Kamus sinonim internal, karena satu bahan bisa muncul dengan nama dagang berbeda-beda dari produsen yang berbeda-beda pula.
Secara teknis, pencocokan ini dilakukan melalui kemiripan vektor embedding (cosine similarity) antara token yang dikenali dan entri basis data, bukan lewat kecocokan teks persis — ini krusial, karena label riil mengandung typo, kapitalisasi tidak konsisten, dan variasi penulisan (Tocopherol vs Tocopheryl Acetate adalah zat berbeda yang mudah tertukar bila hanya dibandingkan sebagai string). Pendekatan fuzzy-matching dan embedding-based retrieval ini dijabarkan dalam riset entity linking untuk istilah biomedis (Wang et al., 2021, dalam konteks penautan entitas medis ke UMLS).
Klasterisasi Berdasarkan Kelas Fungsional
Langkah terakhir adalah memberi tiap bahan yang dikenali sebuah label fungsional: emolien, surfaktan, pengawet, chelator, antioksidan, dan seterusnya. Ini bukan sekadar lookup di tabel CosIng (meski basis data itu memiliki kolom function), melainkan sering kali tugas klasifikasi multi-kelas, karena satu bahan bisa menjalankan beberapa peran sekaligus. Glycerin adalah humektan sekaligus pelarut, dan pada konsentrasi tinggi juga booster pengawet; model harus mempertimbangkan konteks (posisi dalam daftar, bahan di sekitarnya) untuk menentukan fungsi dominan dalam formula tertentu.
| Tahap pemrosesan | Metode | Sumber data |
|---|---|---|
| Tokenisasi | Regex + aturan domain | Kamus internal pola INCI |
| NER | Model mirip BERT (BioBERT, ChemBERTa) | Fine-tuning pada korpus kimia |
| Entity linking | Cosine similarity embedding | CosIng, PubChem |
| Klasterisasi | Klasifikasi multi-kelas | Label fungsional CosIng + konteks posisi |
Arsitektur bertahap semacam ini menjelaskan mengapa pembedahan INCI berbasis AI yang berkualitas tidak hanya menghasilkan daftar "ini zat apa", tapi peta peran fungsional tiap komponen dalam formula — itulah yang mengubah daftar mentah menjadi alat analisis. Lebih lanjut tentang bagaimana klaster fungsional ini berubah menjadi formula jadi, dibahas dalam artikel tentang reformulasi kosmetik dari komposisi INCI kompetitor.
Setelah paham dasar-dasarnya, di bagian selanjutnya kita akan masuk ke algoritma konkret, dari mengambil komposisi kompetitor sampai laporan AI yang jadi. Читать продолжение →
Walker Formulation Academy Club
Menikmati artikel ini? Dapatkan akses ke AI Chemist dan video resep
Asisten AI 24/7 menjawab pertanyaan formulasi, menghitung HLB dan pH, serta membantu Anda memilih bahan. Ditambah komunitas privat sesama ahli kimia dan ulasan produk bulanan.
Tanpa kartu kredit · Batalkan kapan saja