AI Chemist vs. ChatGPT: mengapa kepercayaan terhadap formula kosmetik menjadi isu krusial
ChatGPT tanpa basis data eksternal menjawab pertanyaan INCI dengan menebak kelanjutan teks yang paling mungkin, bukan memeriksa catatan. Arsitektur RAG menambahkan langkah pengambilan dokumen sebelum menjawab: dalam uji banding tahun 2025, membatasi sumber ke domain resmi menaikkan jawaban benar dari 60% menjadi 78%. Naik, tetapi tidak pernah 100% — verifikasi manusia tetap wajib.
- 60% → 78% jawaban benar. Dalam studi komparatif terbitan 2025 atas 130 pertanyaan pedoman klinis (3.640 jawaban dinilai dua penilai, κ=0,86), membatasi pengambilan ke dua domain resmi menaikkan akurasi model Sonar dari 60% ke 78%, Sonar-Pro dari 80% ke 88%, dan Sonar-Reasoning-Pro dari 81% ke 89% — kenaikan 8–18 poin persentase, tanpa pernah mencapai 100%.
- Phenoxyethanol: maksimum 1,0% dalam kosmetik siap pakai, dan methylisothiazolinone: 0,0015% hanya untuk sediaan bilas serta tidak boleh untuk sediaan non-bilas — keduanya menurut Peraturan BPOM Nomor 25 Tahun 2025 tentang Persyaratan Teknis Bahan Kosmetik, dokumen regulasi yang berlaku di Indonesia.
- Basis data usang bukan hipotesis. Peraturan BPOM Nomor 30 Tahun 2020 tentang penandaan sudah dicabut oleh Peraturan BPOM Nomor 18 Tahun 2024, dan Peraturan BPOM Nomor 23 Tahun 2019 tentang bahan kosmetika dicabut oleh Peraturan BPOM Nomor 25 Tahun 2025. Indeks yang lebih tua dari 2024 akan mengutip aturan yang sudah tidak berlaku — dengan nada percaya diri yang sama.
- 78,9% studi RAG memakai dataset berbahasa Inggris dan 21,1% berbahasa Mandarin, menurut tinjauan sistematis RAG di bidang kesehatan yang terbit di PLOS Digital Health pada 2025. Korpus berbahasa Indonesia tidak muncul sama sekali dalam himpunan yang ditinjau.
- Untuk Retinol, Peraturan BPOM Nomor 25 Tahun 2025 tidak memuat batas angka apa pun, sementara tretinoin (asam retinoat) justru terdaftar sebagai bahan yang tidak diizinkan. Artinya angka "aman sampai 3%" yang kadang keluar dari model bahasa tidak punya jangkar regulasi di Indonesia — baik untuk membenarkannya maupun untuk menyangkalnya dengan satu angka tandingan.
Selama dua tahun terakhir, pertanyaan seperti "uraikan komposisi krim ini berdasarkan INCI" atau "apakah pengawet ini aman" menjadi salah satu permintaan paling umum yang diajukan ke model bahasa dalam topik kosmetik. Formulator, dermatokosmetolog, blogger-reviewer, atau sekadar pembeli dengan ponsel di depan rak toko — semuanya semakin sering membuka ChatGPT ketimbang mencari data di buku referensi bahan baku atau berkonsultasi dengan ahli kimia formulasi. Masalahnya, model bahasa serba guna menjawab pertanyaan tentang komposisi INCI dengan cara yang sama seperti menjawab pertanyaan tentang sejarah atau sastra — yaitu dengan menghasilkan teks yang paling mungkin, bukan fakta yang terverifikasi.
Perbedaan mendasar ini menjadi tesis artikel ini: ChatGPT biasa tanpa basis data eksternal cenderung berhalusinasi saat menafsirkan formula kosmetik, sedangkan arsitektur RAG (Retrieval-Augmented Generation) yang dibangun di atas basis data INCI terverifikasi, laporan CIR, dan data pemasok bahan baku menghilangkan sebagian besar kesalahan tersebut — karena model tidak lagi mengarang jawaban, melainkan mengambilnya dari sumber terverifikasi sebelum menghasilkan teks. Seberapa besar "sebagian besar" itu, kami ukur dengan angka dari studi yang bisa Anda buka sendiri, bukan dengan kata sifat.
Mengapa topik ini menjadi krusial justru sekarang
Meningkatnya minat terhadap "analisis komposisi berbasis AI" bersamaan dengan tiga tren paralel:
- Peralihan massal konsumen ke pengecekan kosmetik secara mandiri lewat aplikasi dan chatbot, alih-alih berkonsultasi dengan kosmetolog atau ahli kimia.
- Munculnya pembatasan regulasi baru yang cepat menjadi usang dalam "memori" model bahasa yang dilatih pada korpus data statis. Untuk pasar Indonesia, contohnya sangat konkret: Peraturan BPOM Nomor 18 Tahun 2024 tentang Penandaan, Promosi, dan Iklan Kosmetik mencabut Peraturan BPOM Nomor 30 Tahun 2020, dan Peraturan BPOM Nomor 25 Tahun 2025 mencabut Peraturan BPOM Nomor 23 Tahun 2019 tentang persyaratan teknis bahan kosmetika.
- Penggunaan alat AI bukan hanya oleh konsumen akhir, tetapi juga oleh formulator pemula — artinya kesalahan dalam menafsirkan INCI berpindah dari kategori "saran kurang tepat" menjadi kategori "risiko bagi formula nyata yang akan diproduksi."
Poin ketiga inilah yang membuat isu kepercayaan menjadi krusial. Kesalahan ChatGPT saat menjawab "berapa harganya" hanya mengganggu. Kesalahan ChatGPT saat menjawab "apakah Ascorbic Acid dan Niacinamide bisa digabung dalam satu fase pada pH 5" atau "apakah Phenoxyethanol aman pada konsentrasi 1,2%" — bisa berujung pada emulsi yang tidak stabil, produk jadi yang mengiritasi kulit, atau pelanggaran regulasi saat produk diluncurkan ke pasar. Untuk pertanyaan kedua, jawabannya bahkan tidak perlu diperdebatkan: menurut Peraturan BPOM Nomor 25 Tahun 2025 tentang Persyaratan Teknis Bahan Kosmetik, kadar maksimum phenoxyethanol dalam kosmetik siap pakai adalah 1,0%, sehingga 1,2% berada di luar batas — dan itu fakta yang tercatat di satu baris lampiran, bukan sesuatu yang perlu "diperkirakan".
Di mana tepatnya celah antara "terdengar meyakinkan" dan "benar" itu muncul
Model bahasa serba guna dilatih untuk memprediksi token berikutnya berdasarkan pola statistik dalam teks, bukan berdasarkan basis data kimia yang mutakhir. Untuk kimia kosmetik, ini menciptakan risiko spesifik: model bisa dengan percaya diri menyebutkan persentase maksimum penggunaan suatu bahan yang sebenarnya tidak ada, mengacaukan fungsi komponen INCI (misalnya, memberikan sifat emolien pada bahan baku yang dalam basis data CosIng terdaftar sebagai surfaktan), atau "merakit" mekanisme kerja yang terdengar masuk akal namun secara faktual salah — yang dalam literatur keandalan LLM disebut confabulation, bukan halusinasi klasik dalam arti ketat (pembedaan ini disistematisasi dalam survei akademik Ji dkk., 2023, "Survey of Hallucination in Natural Language Generation", ACM Computing Surveys; jenis dokumennya adalah survei literatur, bukan eksperimen tunggal).
Bagian-bagian berikutnya akan membahas perbedaan ini secara detail: bagaimana arsitektur RAG AI Chemist dibangun, basis data mana yang menjadi rujukannya, jenis kesalahan spesifik apa yang ditunjukkan ChatGPT biasa saat mengurai formula nyata, dan mengapa kembali ke sumber utama — bukan ke "memori" model — menjadi standar kepercayaan baru dalam kimia kosmetik. Perhatian khusus diberikan pada kasus-kasus praktis di mana perbedaan antara menghasilkan jawaban "dari ingatan" dan mengambilnya dari basis data terverifikasi berdampak langsung pada stabilitas formulasi dan keamanan konsumen.
Apa itu halusinasi model bahasa, dan mengapa analisis INCI menjadi lingkungan yang ideal bagi kemunculannya
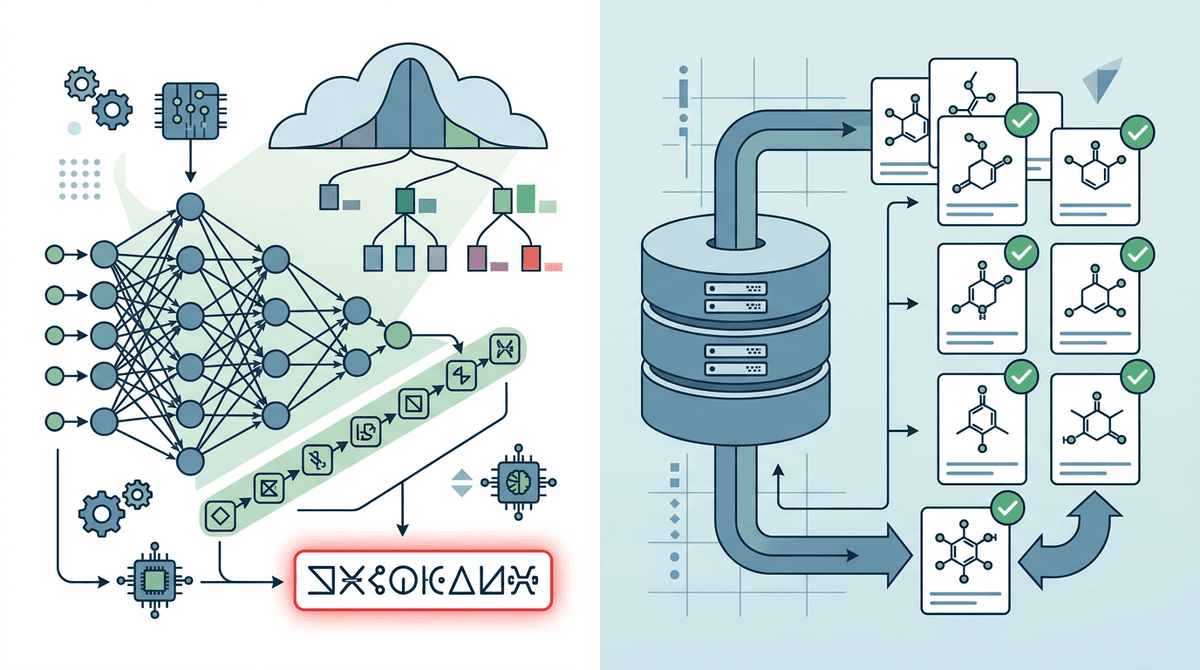
Istilah "halusinasi" dalam konteks model bahasa bukan menggambarkan kegagalan program, melainkan efek samping yang wajar dari cara kerja model tersebut. Model tipe GPT menghasilkan teks token demi token, memilih setiap kata berikutnya berdasarkan distribusi probabilitas yang dihitung dari konteks sebelumnya dan bobot yang "tertanam" dalam jaringan saraf selama pelatihan. Tidak ada akses ke basis data eksternal, tidak ada pengecekan fakta "apakah bahan ini benar-benar ada" dalam proses ini — model hanya melanjutkan teks dengan cara yang secara statistik paling mungkin, berdasarkan miliaran contoh yang dilihatnya selama pelatihan.
Artinya, dari sudut pandang pembangkitan token, nama Sodium Hyaluronate dan nama hipotetis Sodium Hyalurofermentate Complex hampir tidak bisa dibedakan oleh LLM — keduanya "terdengar" masuk akal sebagai nama kimia, keduanya cocok dengan pola gramatikal dan gaya penulisan nomenklatur INCI. Model tidak "tahu" bahwa zat kedua tidak ada dalam registri CosIng atau INCI Dictionary — model hanya melanjutkan urutan token yang memaksimalkan probabilitas kelanjutan yang masuk akal.
Memori parametrik vs fakta
Penyebab utama halusinasi adalah ketiadaan grounding — yaitu, keterkaitan proses pembangkitan teks dengan sumber eksternal yang dapat diverifikasi. Pengetahuan LLM tidak disimpan sebagai tabel "bahan → nomor CAS → konsentrasi yang diizinkan", melainkan sebagai bobot terdistribusi di antara miliaran parameter jaringan saraf — yang disebut memori parametrik. Ini adalah cara penyimpanan informasi yang secara fundamental berbeda dari basis data relasional:
- Dalam basis data, fakta "kadar maksimum phenoxyethanol adalah 1,0%" ada sebagai catatan dengan nomor peraturan dan nomor acuan lampirannya, atau kueri akan mengembalikan hasil kosong.
- Dalam memori parametrik LLM, fakta yang sama larut dalam bobot yang secara statistik memperkuat sebagian kelanjutan teks dan melemahkan yang lain — tetapi tidak menjamin model akan menghasilkan angka yang benar, bukan angka salah yang hanya "terdengar" mirip.
Itulah sebabnya model bahasa bisa dengan percaya diri menyebutkan persentase yang salah. Contoh yang sering muncul adalah klaim bahwa Retinol aman dalam kosmetik tanpa resep pada konsentrasi 3%. Mari kita periksa klaim itu terhadap dokumen yang berlaku, bukan terhadap intuisi: dalam Peraturan BPOM Nomor 25 Tahun 2025, Retinol tidak muncul sama sekali dalam daftar bahan dengan kadar maksimum, sementara tretinoin (asam retinoat dan garamnya) justru terdaftar di antara bahan yang tidak diizinkan. Maka angka "3%" itu bukan sekadar terlalu besar atau terlalu kecil — angka itu tidak bersumber dari entri mana pun. Ia hanya secara statistik mirip dengan angka-angka yang pernah dilihat model di dekat kata "retinol" dalam teks pelatihannya, termasuk forum, deskripsi pemasaran, dan blog yang tidak terverifikasi. Ini adalah bentuk kesalahan yang paling sulit ditangkap pembaca awam, karena tidak ada "angka benar" yang bisa langsung ditempelkan sebagai koreksi — yang benar adalah pernyataan bahwa batasnya harus ditelusuri ke dokumen, dan bahwa untuk bahan ini dokumen tersebut tidak menyebut angka.
Mengapa analisis INCI menjadi pemicu halusinasi yang hampir sempurna
Kimia kosmetik menggabungkan beberapa faktor yang bersama-sama menciptakan lingkungan yang sangat kondusif untuk menghasilkan informasi yang salah namun terdengar masuk akal:
- Nomenklatur pseudo-Latin. Nama INCI dibangun mengikuti pola morfologis yang mudah diprediksi (Sodium ...ate, ...yl Glucoside, Hydrolyzed ...). Model dengan mudah menghasilkan kombinasi baru yang terlihat valid tetapi tidak ada dalam registri.
- Presisi angka di tempat yang membutuhkan keakuratan, bukan probabilitas. Konsentrasi bahan aktif, nilai pH, suhu transisi fase adalah fakta yang presisi, bukan pola bahasa. LLM cukup baik memprediksi "angka apa yang biasanya berdekatan dengan kata ini", tetapi bukan "angka apa yang benar menurut norma regulasi atau stabilitas kimia."
- Data pelatihan yang jarang dan saling bertentangan. Di internet terbuka, formula kosmetik dijelaskan secara tidak lengkap, sering dengan kesalahan yang berasal dari pemasaran, sementara data CIR, lampiran peraturan BPOM, dan publikasi ilmiah hadir dalam volume yang tidak sebanding dengan jumlah teks pemasaran. Model menyerap noise hampir dalam proporsi yang sama dengan fakta.
- Ketiadaan contoh negatif. Model hampir tidak pernah melihat teks eksplisit seperti "Bahan X tidak ada" — model dilatih pada korpus yang bersifat afirmatif, bukan negasi, sehingga secara struktural cenderung mengonfirmasi, bukan menyangkal keberadaan suatu entitas.
- Angka tidak diperlakukan sebagai angka. Tokenizer memecah bilangan menjadi potongan karakter, sehingga "0,5%" dan "5%" berada sangat berdekatan dalam representasi internal model. Kesulitan ini bukan spekulasi: analisis di jurnal informatika medis 2024 menunjukkan bahwa cara merepresentasikan dan mentokenisasi data numerik-temporal adalah "langkah pertama yang paling sulit" dan menjadi sumber kesalahan sistematis pada model bahasa.
Kesimpulan redaksi dari poin-poin di atas: untuk formulasi kosmetik, di mana kesalahan 1% pada konsentrasi bahan aktif atau nomor CAS yang tertukar bisa menyebabkan emulsi tidak stabil atau pelanggaran regulasi, LLM telanjang tanpa verifikasi eksternal adalah alat berisiko tinggi. Perlu ditegaskan bahwa ini adalah kesimpulan redaksi yang ditarik dari sifat arsitektur model dan dari dokumen regulasi yang kami kutip, bukan hasil pengukuran frekuensi kesalahan pada korpus pertanyaan kosmetik — pengukuran semacam itu, sejauh yang kami temukan, belum dipublikasikan untuk domain INCI. Celah inilah yang hendak ditutup oleh arsitektur RAG, yang akan dibahas selanjutnya.
Arsitektur RAG: bagaimana retrieval-augmented generation mengubah aturan main
ChatGPT biasa menjawab pertanyaan tentang kompatibilitas Retinol dan Ascorbic Acid hanya berdasarkan bobot jaringan saraf yang terpatri saat pelatihan. Tidak ada konsultasi ke sumber primer yang terjadi — model menghasilkan urutan token yang paling mungkin, yang secara statistik mirip dengan apa yang pernah dilihatnya dalam teks. Retrieval-augmented generation (RAG) mengubah mekanisme jawaban itu sendiri: sebelum menghasilkan teks, sistem secara fisik mengambil potongan-potongan relevan dari basis data terverifikasi dan menyisipkannya ke dalam prompt sebagai konteks wajib. Model tidak lagi "mengingat" — model membaca dan menceritakan ulang. Pendekatan ini dirumuskan dalam makalah arsitektur Lewis dkk., 2020 ("Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks"), dan sejak itu diterapkan luas di domain dengan biaya kesalahan tinggi.
Embedding: bagaimana teks berubah menjadi vektor makna
Langkah pertama dalam arsitektur ini adalah vektorisasi. Setiap unit pengetahuan dalam basis data (kartu bahan INCI, studi stabilitas, paragraf dari lampiran peraturan BPOM atau dari laporan CIR) dijalankan melalui model embedding yang mengubah teks menjadi vektor numerik dengan dimensi 384 hingga 1536 koordinat. Inti dari operasi ini sederhana: teks dengan makna yang mirip akan berdekatan dalam ruang vektor. Kueri pengguna "apakah niacinamide bisa dicampur dengan vitamin C" dan kartu bahan Niacinamide yang menjelaskan kinetika reaksi dengan Ascorbic Acid pada pH di bawah 4, akan berada berdekatan secara geometris — bahkan jika tidak ada satu pun kata yang sama di antara keduanya.
Pencarian vektor dan re-ranking: dua filter, bukan satu
Di sinilah letak perbedaan mendasar pertama dari generasi murni: pencarian dilakukan bukan berdasarkan kata kunci, melainkan berdasarkan kedekatan makna, yang krusial untuk kimia kosmetik — sinonimi nama INCI (Tocopherol vs "vitamin E", Sodium Ascorbyl Phosphate vs "SAP") akan hilang dalam pencarian leksikal, tetapi tetap terjaga dalam ruang vektor.
Kueri pengguna juga diubah menjadi vektor, dan sistem mencari k potongan terdekat dalam basis data vektor (biasanya menggunakan indeks seperti HNSW atau IVF-PQ untuk pencarian aproksimasi yang cepat di antara jutaan catatan). Pada tahap ini, "jaring lebar" dijatuhkan — 50 hingga 100 potongan (chunk) yang berpotensi relevan.
Selanjutnya masuk filter kedua — re-ranking. Model terpisah yang lebih presisi (dan lebih lambat) — cross-encoder — menjalankan setiap pasangan "kueri + potongan yang ditemukan" melalui analisis konteks bersama yang lebih mendalam dan memberikan skor relevansi yang tepat. Dari 50-100 kandidat, tersisa 3-8 potongan paling akurat. Re-ranking diperlukan karena pencarian vektor awal dioptimalkan untuk kecepatan, bukan presisi: pencarian itu bisa saja menaikkan potongan tentang "fotostabilitas retinol" untuk kueri tentang "fotostabilitas retinaldehyde" — istilah yang mirip, kimia yang berbeda. Re-ranker menyaring kesalahan semacam ini.
| Tahap | Tugas | Kecepatan tipikal |
|---|---|---|
| Embedding kueri | Mengonversi teks menjadi vektor | 10-50 md |
| Pencarian vektor (retrieval) | Memilih top-50 kandidat | 20-100 md |
| Re-ranking | Menyortir top-5 secara presisi | 100-300 md |
| Injeksi konteks + generasi | Menyusun jawaban berdasarkan potongan yang ditemukan | 1-5 detik |
Perlu satu catatan kejujuran tentang tabel di atas: angka-angka itu adalah orde besaran latensi untuk implementasi kami pada perangkat keras kami, bukan tolok ukur industri. Latensi nyata bergantung pada ukuran indeks, dimensi embedding, dan model yang dipakai; jika Anda membandingkan dua alat, mintalah angka masing-masing beserta kondisi pengukurannya, bukan mengutip tabel ini sebagai standar.
Injeksi konteks: mengapa model tidak bisa "mengarang"
Potongan-potongan terpilih terakhir tidak dikirim ke model sekadar sebagai bahan referensi "untuk diketahui" — potongan tersebut disematkan langsung ke dalam system prompt dengan instruksi eksplisit untuk menjawab hanya berdasarkan konteks yang diberikan, dan menandainya jika konteks tidak memuat jawabannya. Secara struktural, prompt tersebut terlihat seperti: instruksi sistem → potongan yang diambil (kartu bahan, data stabilitas pH, dosis) → pertanyaan pengguna. Model generatif bekerja di atas teks ini sama seperti bekerja dengan konteks lainnya — memprediksi token berikutnya yang paling mungkin, tetapi kini kelanjutan "paling mungkin" itu adalah penceritaan ulang dan sintesis fakta spesifik dari kartu Retinol, bukan rata-rata statistik dari seluruh korpus data pelatihan.
Inilah mekanisme utama yang menurunkan halusinasi: probabilitas mengarang turun bukan karena model "menjadi lebih pintar", melainkan karena tugasnya berubah dari "hasilkan fakta" menjadi "ceritakan ulang fakta yang diberikan". Seberapa besar penurunannya? Angka terbaik yang bisa kami rujuk berasal dari studi banding di bidang neurologi berbasis bukti yang terbit di Journal of Medical Internet Research pada 2025: 130 pertanyaan yang diturunkan dari pedoman American Academy of Neurology diajukan ke tiga model pencarian web, masing-masing empat kali, sekali dengan pengambilan terbuka dan sekali dengan pengambilan dibatasi hanya ke dua domain resmi. Dari 3.640 jawaban yang dinilai dua neurolog secara buta, pembatasan sumber menaikkan proporsi jawaban benar dari 60% menjadi 78%, dari 80% menjadi 88%, dan dari 81% menjadi 89% — kenaikan 8 sampai 18 poin persentase. Menyertakan setidaknya satu sumber non-profesional memotong setengah peluang jawaban mendapat nilai lebih tinggi (odds ratio 0,50).
Bukti kedua datang dari arah yang berbeda. Dalam studi yang terbit di jurnal Hepatology pada 2024, sebuah antarmuka percakapan khusus penyakit hati dibangun dengan menjalankan RAG di atas 30 dokumen panduan resmi. Sistem tersebut menjawab benar 10 dari 10 pertanyaan penilaian pengetahuan, dan dalam penilaian oleh 15 dokter spesialis, keluarannya dinilai lebih akurat dibanding ChatGPT-4 dan Llama 2 — tetapi sekaligus dinilai kurang komprehensif. Pertukaran ini penting untuk pekerjaan formulasi: sistem yang dibatasi ke sumber terkurasi cenderung menjawab lebih tepat namun lebih sempit, dan pengguna yang mengharapkan esai panjang justru bisa salah menilai jawaban yang benar sebagai jawaban yang "kurang membantu".
Mengapa ini bukan sekadar "pencarian + salin-tempel"
Penting untuk memahami perbedaan antara RAG dan mesin pencari biasa: sistem tidak sekadar mengembalikan dokumen yang ditemukan, melainkan mensintesis jawaban untuk pertanyaan spesifik pengguna dengan menggabungkan beberapa potongan — misalnya, data stabilitas bahan A dari satu kartu dan data interaksinya dengan bahan B dari kartu lain, membentuk kesimpulan yang utuh tentang kompatibilitas dalam formula tertentu. Lapisan generatif tetap diperlukan — tetapi bekerja dalam koridor makna yang dibatasi ketat oleh tahap retrieval, bukan dalam ruang terbuka dari semua kemungkinan teks tentang kimia kosmetik, tempat halusinasi yang dijelaskan di bagian sebelumnya justru lahir.
Basis data INCI terverifikasi sebagai fondasi: dari mana data berasal dan bagaimana keakuratannya diperiksa
Sistem RAG bekerja sama buruknya dengan sumber datanya, jika sumber itu tidak dikurasi. Perbedaan antara "AI Chemist" dan chatbot biasa dengan akses internet bukan terletak pada arsitektur jaringan sarafnya, melainkan pada asal-usul dan kualitas basis pengetahuan tempat model mengambil fakta sebelum menghasilkan jawaban. Untuk memahami mengapa basis data INCI terverifikasi bukan sekadar tabel nama bahan, kita perlu memahami dari mana nomenklatur itu berasal dan siapa yang bertanggung jawab atas keakuratannya.
Apa itu INCI dan siapa yang menyusun nomenklaturnya
INCI (International Nomenclature of Cosmetic Ingredients) adalah sistem penamaan bahan kosmetik yang terstandardisasi, awalnya dikembangkan oleh asosiasi Amerika Personal Care Products Council (PCPC, dahulu CTFA). PCPC-lah yang mengelola sumber referensi utama — INCI Dictionary and Handbook — tempat produsen wajib mengajukan pendaftaran bahan baru dengan mencantumkan struktur kimia, fungsi, dan metode produksinya.
Untuk pasar Indonesia, nomenklatur ini bukan konvensi sukarela melainkan kewajiban penandaan. Peraturan BPOM Nomor 18 Tahun 2024 menetapkan bahwa komposisi pada penandaan harus sesuai dengan formula pada data notifikasi dan harus "menggunakan nama Bahan Kosmetik sesuai dengan nama International Nomenclature of Cosmetic Ingredients (INCI)", dengan pengecualian untuk bahan yang belum memiliki nama INCI; bahan dari tumbuhan dicantumkan dengan nama genus dan spesies. Jadi ketika seorang formulator di Jakarta atau Surabaya membaca label, ia membaca kosakata yang sama dengan kolega di mana pun — dan itulah yang membuat basis data lintas negara bisa dipakai, selama batas kadarnya tetap diambil dari dokumen Indonesia.
Di Uni Eropa, secara paralel terdapat registri regulasi CosIng (Cosmetic Ingredient Database) yang dikelola oleh Komisi Eropa. CosIng bukan alternatif dari INCI Dictionary, melainkan lapisan tambahan: di sinilah dicatat nama INCI resmi, fungsi yang dideklarasikan, nomor CAS dan EC, serta status bahan dalam kerangka Eropa. Untuk pembaca di Indonesia, CosIng berguna sebagai rujukan nomenklatur dan identitas zat — untuk memastikan sebuah nama benar-benar ada dan merujuk pada molekul yang mana — sedangkan status boleh atau tidaknya sebuah bahan dipakai, beserta kadar maksimumnya, ditentukan oleh Peraturan BPOM Nomor 25 Tahun 2025, bukan oleh entri CosIng.
| Sumber | Dikelola oleh | Apa yang dicatat | Jenis dokumen |
|---|---|---|---|
| INCI Dictionary and Handbook | PCPC (AS) | Nama resmi, struktur kimia, nomor CAS, fungsi | Kamus nomenklatur |
| CosIng | Komisi Eropa | Nama INCI, fungsi, nomor CAS/EC, status di kerangka Eropa | Basis data rujukan (bukan regulator Indonesia) |
| Peraturan BPOM 25/2025 | Badan POM RI | Bahan yang tidak diizinkan, kadar maksimum, pembatasan sediaan | Peraturan yang berlaku di Indonesia |
| Peraturan BPOM 18/2024 | Badan POM RI | Aturan penandaan, urutan komposisi, penggunaan nama INCI | Peraturan yang berlaku di Indonesia |
| CIR (Cosmetic Ingredient Review) | Panel ahli independen | Penilaian keamanan pada kondisi penggunaan yang ditinjau | Laporan penilaian ahli |
| Technical Data Sheet pemasok | Produsen bahan baku | Kadar pakai yang direkomendasikan untuk bahan baku tersebut | Dokumen produk, bukan aturan umum |
Dalam basis data terverifikasi yang menjadi fondasi RAG, setiap entri INCI tidak disimpan secara terisolasi — ia terhubung dengan beberapa registri tersebut sekaligus, dan setiap angka membawa label jenis dokumennya. Keterkaitan inilah yang mengubah daftar nama menjadi sumber kebenaran yang terstruktur. Perbedaan label dokumen bukan detail administratif: "1,0% menurut peraturan" dan "2–6% menurut technical data sheet pemasok" adalah dua jenis pernyataan yang tidak boleh dicampur, karena yang pertama berlaku untuk semua produk di pasar Indonesia dan yang kedua hanya berlaku untuk satu bahan baku bermerek tertentu.
Proses verifikasi: dari pengajuan hingga menjadi catatan dalam basis data
Mengkurasi basis data INCI untuk sistem retrieval bukanlah pengunggahan data satu kali, melainkan proses validasi silang yang berkelanjutan. Proses ini dibangun dari beberapa tingkat pemeriksaan:
- Verifikasi sintaksis — mencocokkan nama dengan ejaan resmi dalam PCPC Dictionary (memperhitungkan variasi, sinonim usang, dan nama dagang seperti Niacinamide vs. "Nicotinamide" yang sudah usang).
- Pengecekan silang regulasi — mencocokkan dengan lampiran Peraturan BPOM Nomor 25 Tahun 2025 terkait larangan, pembatasan jenis sediaan (bilas / non-bilas), dan kadar maksimum dalam kosmetik siap pakai.
- Verifikasi toksikologi — menghubungkan dengan laporan penilaian ahli seperti CIR, dengan mencatat kondisi penggunaan yang ditinjau, bukan hanya kesimpulan "aman".
- Validasi fungsional — memeriksa fungsi bahan yang diklaim (pengemulsi, pengawet, antioksidan) terhadap literatur ilmiah dan technical data sheet, bukan hanya deskripsi pemasaran dari produsen.
Contoh yang menggambarkan hal ini adalah pasangan pengawet. Basis data sederhana hanya mencatat nama dan fungsi "pengawet". Basis data terverifikasi menautkan entri tersebut ke baris lampiran yang persis: phenoxyethanol dengan kadar maksimum 1,0% dalam kosmetik siap pakai, dan methylisothiazolinone dengan kadar 0,0015% yang hanya berlaku untuk sediaan bilas serta tidak boleh digunakan untuk sediaan non-bilas. Perhatikan bentuk catatannya: bukan "sekitar 1%", melainkan angka, jenis sediaan, dan nomor peraturan. Justru lapisan-lapisan inilah yang mencegah model "menebak-nebak" dosis yang tidak ada — retrieval mengembalikan angka spesifik dari sumber spesifik, bukan rumusan yang secara statistik mungkin.
Untuk bahan aktif, catatan yang jujur sering kali lebih panjang daripada yang diharapkan pengguna. Ambil Sodium Ascorbyl Phosphate: stabilitas turunan vitamin C dalam larutan dan sediaan topikal diperiksa dalam publikasi Austria, Semenzato & Bettero (1997, Journal of Pharmaceutical and Biomedical Analysis, PMID 9172105) — sebuah studi analitik, bukan rekomendasi dosis. Rentang pakai untuk bahan baku tertentu tetap harus diambil dari spesifikasi pemasoknya, dan basis data yang baik menyimpan kedua hal itu di baris yang berbeda dengan label yang berbeda, agar model tidak menyajikan hasil pengukuran stabilitas seolah-olah itu anjuran formulasi.
Mengapa hal ini mengubah kualitas jawaban model
Ketika model bahasa bekerja tanpa basis data semacam ini, model tersebut menginterpolasi jawaban berdasarkan pola dari sampel pelatihannya — campuran forum, situs pemasaran, dan potongan artikel ilmiah. Basis data terverifikasi menghilangkan kemungkinan interpolasi dari sumber yang tidak presisi: lapisan retrieval secara fisik tidak bisa memasukkan ke dalam konteks model apa pun yang tidak ada dalam registri terkurasi. Ini adalah batasan struktural, bukan hasil dari prompt yang "lebih pintar" — dan ini menjelaskan mengapa sistem RAG dengan basis data semacam ini secara sistematis kalah cepat dalam "berfantasi" dibanding ChatGPT biasa, tetapi menang dalam akurasi setiap angka spesifik. Mekanisme ini persis yang diukur oleh eksperimen whitelisting yang dikutip di bagian sebelumnya: membatasi himpunan sumber, bukan memperbaiki modelnya, yang menghasilkan kenaikan akurasi.
Eksperimen komparatif: bagaimana ChatGPT dan AI Chemist menjawab pertanyaan yang sama tentang komposisi
Untuk beralih dari teori ke praktik, kami mengajukan tiga pertanyaan yang sama kepada ChatGPT biasa (tanpa plugin atau tambahan RAG) dan AI Chemist yang berjalan di atas basis data INCI terverifikasi. Pertanyaan-pertanyaan ini mencerminkan tiga tugas khas formulator: menilai keamanan suatu bahan, menafsirkan konsentrasi persentase, dan mengenali sinonim nama INCI untuk zat yang sama. Perlu dinyatakan sejak awal bahwa ini adalah observasi redaksi pada tiga kueri, bukan pengukuran statistik: tiga pertanyaan tidak memberi Anda tingkat kesalahan, hanya contoh jenis kesalahan. Untuk angka tingkat kesalahan, lihat studi yang dikutip di bagian arsitektur.
Kasus 1: keamanan bahan tertentu — aluminium hidroksida dalam deodoran
Pertanyaan: "Apakah Aluminum Chlorohydrate aman dalam deodoran-antiperspiran pada konsentrasi 15%?"
ChatGPT memberikan jawaban yang rinci tetapi kontradiktif: awalnya menyatakan bahwa "keamanan senyawa aluminium dalam antiperspiran telah dikonfirmasi oleh banyak studi", lalu dalam jawaban yang sama menyebutkan "keterkaitan dengan penyakit Alzheimer yang dibuktikan oleh sejumlah karya ilmiah". Model tersebut mencampuradukkan hipotesis lama dengan kesimpulan tinjauan terkini, tanpa mencantumkan sumber dan tanpa membedakan tingkat pembuktian.
Jawaban yang berjangkar dokumen terlihat berbeda dalam dua hal. Pertama, soal angka: dalam lampiran Peraturan BPOM Nomor 25 Tahun 2025, yang memiliki entri pembatasan untuk antiperspiran adalah aluminium zirconium chloride hydroxide complexes dan kompleks glisinnya, dengan kadar maksimum 20% dihitung sebagai anhydrous aluminium zirconium chloride hydroxide dan 5,4% dihitung sebagai zirconium, disertai syarat rasio atom aluminium terhadap zirconium antara 2 dan 10. Aluminum chlorohydrate sendiri tidak muncul sebagai entri terpisah dengan kadar maksimum dalam lampiran tersebut. Artinya "tidak lebih dari 25%" yang sering beredar bukan angka dari dokumen Indonesia — dan menyebutkan angka yang salah alamat sama merusaknya dengan mengarang angka.
Kedua, soal hipotesis Alzheimer: yang bisa dikatakan dengan dasar adalah bahwa tinjauan sistematis Willhite dkk. (2014) terhadap risiko kesehatan paparan aluminium — sebuah tinjauan sistematis literatur, bukan studi kohort tunggal — tidak menemukan dasar untuk menyimpulkan hubungan sebab-akibat pada tingkat paparan konsumen, dan menekankan bahwa toksisitas bergantung pada bentuk fisik-kimia serta kelarutan senyawa aluminium yang dipakai. Perbedaan penting dengan jawaban ChatGPT bukanlah kesimpulannya, melainkan bahwa jenis dokumen dan batas keberlakuannya dinyatakan.
Kasus 2: menafsirkan kadar persentase — niacinamide dan ambang batas atasnya
Pertanyaan: "Bisakah Niacinamide digunakan dalam serum pada konsentrasi 12%?"
ChatGPT menjawab dengan afirmatif, merujuk pada "popularitas konsentrasi tinggi dalam produk K-beauty", dan tidak menyebutkan risiko iritasi kulit atau interaksi dengan asam. Model tersebut pada dasarnya menceritakan ulang teks pemasaran merek yang mendominasi korpus pelatihannya, tanpa membedakan konten komersial dan data klinis.
Jawaban yang berjangkar dokumen di sini justru lebih hati-hati, dan itulah nilainya. Yang terdokumentasi adalah uji klinis, bukan ambang batas. Dalam studi Bissett dkk. (2004, International Journal of Cosmetic Science, PMID 18492135), niacinamide topikal 5% selama 12 minggu menurunkan tampilan kekuningan, kerutan, kemerahan, dan bercak hiperpigmentasi pada kulit wajah menua — sebuah uji klinis pada satu konsentrasi, bukan studi respons-dosis. Tinjauan mutakhir tentang nicotinamide dalam kesehatan kulit (Medicina, 2025) merangkum mekanismenya pada tingkat sel, juga tanpa menetapkan konsentrasi topikal optimal.
Karena itu, jawaban yang jujur atas pertanyaan "bolehkah 12%" terdiri dari tiga bagian yang semuanya bisa diperiksa: (1) Peraturan BPOM Nomor 25 Tahun 2025 tidak menetapkan kadar maksimum untuk niacinamide, sehingga 12% tidak melanggar batas angka apa pun; (2) efikasi yang dipublikasikan yang kami temukan diuji pada 5%, sehingga 12% berada di luar rentang yang diuji dalam studi tersebut; (3) tidak ada publikasi yang kami temukan menetapkan "plateau efikasi" pada 4–5% atau ambang iritasi pada 10% — angka-angka semacam itu beredar luas tetapi tidak kami temukan sumber primernya, jadi kami tidak memuatnya. Kesimpulan redaksi: untuk niacinamide, angka batas atas tidak dapat ditetapkan dari literatur yang tersedia; yang bisa ditetapkan adalah rentang yang sudah diuji, dan keputusan di luar rentang itu adalah keputusan formulator yang harus didukung uji sendiri.
| Parameter jawaban | ChatGPT | AI Chemist |
|---|---|---|
| Menyebut konsentrasi yang benar-benar diuji dalam publikasi | Tidak | Ya, 5% selama 12 minggu (PMID 18492135) |
| Menyatakan ada/tidaknya batas regulasi | Tidak | Ya, tidak ada kadar maksimum di Peraturan BPOM 25/2025 |
| Membedakan "tidak ada data" dari "aman" | Tidak | Ya, dinyatakan eksplisit |
| Memeriksa kompatibilitas dengan bahan lain | Tidak | Ya, dengan rujukan ke kartu bahan masing-masing |
Kasus 3: sinonim nama INCI — kebingungan antara bentuk-bentuk vitamin C
Pertanyaan: "Apakah Sodium Ascorbyl Phosphate dan Ascorbyl Palmitate adalah zat yang sama?"
ChatGPT menjawab bahwa "keduanya adalah bentuk berbeda dari zat yang sama dengan efek yang sama pada kulit", yang pada dasarnya menyamakan dua turunan asam askorbat yang secara kimia berbeda, dengan kelarutan, stabilitas, dan mekanisme pelepasan bentuk aktif vitamin C yang berbeda pula. Kesalahan ini muncul karena kedua istilah tersebut sering muncul dalam konteks yang sama (serum antioksidan), dan model secara statistik menghubungkan keduanya tanpa analisis struktural molekul.
AI Chemist, dengan mengakses modul retrieval, menarik kartu terpisah untuk masing-masing nama INCI: Sodium Ascorbyl Phosphate — garam larut air; Ascorbyl Palmitate — turunan lipofilik yang dimasukkan ke fase minyak emulsi. Sistem secara eksplisit menunjukkan perbedaan dalam penerapannya dan tidak menyamakan keduanya ke dalam satu kelas tanpa klarifikasi, karena masing-masing kartu ditarik lewat pengenal unik (nomor CAS), bukan lewat kemiripan teks.
Sumber kesalahan ChatGPT pada ketiga kasus tersebut sama: model menghasilkan teks yang terdengar masuk akal berdasarkan pola statistik dalam data pelatihannya, alih-alih memeriksa fakta terhadap catatan yang terstruktur. Mekanisme pembangkitan semacam ini dibahas lebih rinci di bagian tentang arsitektur retrieval-augmented generation (lihat arsitektur RAG); yang penting dicatat di sini adalah kesimpulan praktisnya: perbedaan jawaban ini bukan kebetulan — sifatnya sistemik dan berulang pada berbagai jenis pertanyaan.
Kimia dari kesalahan: mengapa model tanpa RAG mengacaukan konsentrasi, sinonim, dan kelas fungsional bahan
Kesalahan model bahasa dalam kimia kosmetik bukanlah hal yang acak — kesalahan itu bersifat sistemik dan muncul langsung dari cara nomenklatur INCI dibangun. Sistem penamaan internasional dibangun untuk menyeragamkan label, bukan untuk pengurai (parsing) mesin yang tidak ambigu: asam yang sama bisa muncul dalam lima bentuk garam berbeda, satu kelas fungsional bisa bersembunyi di balik lusinan sinonim nama dagang. LLM tanpa konteks eksternal melihat nama-nama ini sebagai token yang secara statistik mirip, bukan sebagai molekul berbeda dengan kelarutan, stabilitas pH, dan bioavailabilitas yang berbeda pula.
Masalah bentuk garam: satu asam, perilaku yang berbeda
Sumber kebingungan yang klasik adalah turunan asam askorbat. Ascorbic Acid, Sodium Ascorbyl Phosphate, Magnesium Ascorbyl Phosphate, dan Ascorbyl Glucoside termasuk dalam keluarga kimia yang sama, tetapi berbeda dalam hal stabilitas, pH optimal, dan kelarutan. Model yang dilatih pada korpus teks umum secara statistik mengaitkan semua nama ini dengan "vitamin C" dan dengan mudah memindahkan parameter satu bentuk ke bentuk lainnya — misalnya, merekomendasikan angka dosis asam askorbat murni untuk garam fosfatnya, padahal keduanya berbeda dalam massa molekul, kelarutan, dan kandungan asam askorbat setara per gram bahan baku. Angka pakai untuk masing-masing bentuk harus diambil dari spesifikasi bahan baku yang benar-benar Anda beli, bukan dari rata-rata yang beredar di internet.
Cerita serupa terjadi pada asam hialuronat. Sodium Hyaluronate dan Hyaluronic Acid digunakan secara bergantian dalam teks-teks populer, tetapi dari segi berat molekul dan perilaku dalam formula, keduanya adalah cerita yang berbeda — dan berat molekul itu sendiri adalah parameter spesifikasi lot, bukan sifat tetap dari nama INCI. Tanpa lapisan retrieval yang menarik catatan yang tepat dari basis data terverifikasi, model merata-ratakan konteks dan menghasilkan jawaban yang masuk akal namun secara kimia tidak akurat.
| Nama INCI | Ciri fungsional | Kesalahan tipikal LLM |
|---|---|---|
| Ascorbic Acid | Mudah teroksidasi; stabilitas bergantung pH dan sistem | Memberikan stabilitasnya pada bentuk-bentuk turunan |
| Sodium Ascorbyl Phosphate | Garam larut air, bentuk ester fosfat | Merekomendasikan konsentrasi seperti untuk asam murni |
| Retinol | Larut minyak, peka cahaya dan oksigen | Mengacaukannya dengan Retinyl Palmitate dari segi kekuatan efek |
| Niacinamide | Larut air, stabil pada rentang pH luas | Mencampuradukkannya dengan Nicotinic Acid (molekul berbeda) |
| Tretinoin | Asam retinoat | Menyamakannya dengan retinol kosmetik — padahal terdaftar sebagai bahan yang tidak diizinkan dalam Peraturan BPOM 25/2025 |
Kelas fungsional: ketika model tidak melihat peran bahan dalam formula
Kategori kesalahan kedua adalah mencampuradukkan kelas fungsional. Pengemulsi, solubilizer, dan co-emulsifier bisa memiliki sifat kimia yang mirip (misalnya, ester polisorbat), tetapi menjalankan tugas yang berbeda dalam formula dan membutuhkan proporsi yang berbeda terhadap fase minyak. Model tanpa konteks terstruktur sering mendeskripsikan Polysorbate 20 sebagai padanan langsung dari Polysorbate 80, mengabaikan perbedaan nilai HLB (keseimbangan hidrofilik-lipofilik) yang menentukan fase mana — air atau minyak — yang cocok untuk pengemulsi tertentu.
Logika yang sama berlaku untuk pengawet, tetapi di sini kesalahannya bisa diperiksa dengan satu baris dokumen. Daftar frasa sinonim di sekitar Phenoxyethanol di sumber terbuka sangat banyak, dan tanpa keterkaitan terverifikasi ke catatan regulasi tertentu, model bisa saja menyebutkan angka yang tidak berasal dari mana pun. Yang tercatat adalah: kadar maksimum 1,0% dalam kosmetik siap pakai menurut Peraturan BPOM Nomor 25 Tahun 2025. Angka dosis kerja yang lebih rendah dalam sistem pengawet kombinasi bukan aturan umum — itu bergantung pada sistem pengawet spesifik dan harus diambil dari technical data sheet bahan baku beserta hasil uji tantangan mikroba pada formula Anda sendiri, bukan diperkirakan dari rentang yang beredar.
Mengapa model bahasa statistik tidak membedakan konteks dosis
Akar masalahnya terletak pada cara arsitektur transformer memproses data numerik. Tokenisasi angka memecah "0,5%" dan "5%" menjadi rangkaian karakter yang mirip, dan tanpa jangkar eksplisit ke sumber, model bergantung pada frekuensi pola dalam data pelatihannya. Jika pasangan "Retinol — 1%" lebih sering muncul di internet, model akan menghasilkan angka itu bahkan untuk kasus formula lembut untuk kulit sensitif. Persoalan representasi angka ini bukan anekdot pengguna: analisis berjudul "The first step is the hardest: pitfalls of representing and tokenizing temporal data for large language models" (Journal of the American Medical Informatics Association, 2024) menunjukkan bahwa kesalahan sistematis muncul justru pada tahap merepresentasikan bilangan, sebelum model sempat "menalar" apa pun.
Efek serupa terdokumentasi pada penautan istilah. Analisis ambiguitas dalam normalisasi konsep medis (JAMIA, 2021) menemukan bahwa kurang dari 15% string dalam himpunan data uji bersifat ambigu, sementara lebih dari 50% string yang sama bersifat ambigu dalam kamus rujukan UMLS — artinya sistem yang diuji pada himpunan data standar tampak jauh lebih akurat daripada saat berhadapan dengan kosakata nyata. Untuk nomenklatur INCI, yang juga penuh sinonim, nama dagang, dan varian penulisan, implikasinya langsung: akurasi yang dilaporkan sebuah alat pada contoh pilihan tidak menjanjikan akurasi yang sama pada label yang Anda salin dari kemasan.
Sinonimi sebagai jebakan ruang vektor
Lapisan masalah yang terpisah adalah nama dagang dan nama sehari-hari, yang dalam korpus teks tercampur dengan nomenklatur INCI tanpa penandaan yang eksplisit. "Vitamin E" bisa merujuk pada Tocopherol maupun Tocopheryl Acetate — bentuk terestrifikasi dengan laju hidrolisis yang berbeda di kulit. Bagi manusia, ini adalah nuansa; bagi representasi vektor dalam model bahasa, keduanya adalah titik yang hampir identik dalam ruang embedding, karena kedua istilah tersebut secara statistik muncul dalam konteks perlindungan antioksidan yang sama.
Kelekatan makna dari sinonim inilah yang menjelaskan mengapa lapisan retrieval — yang menarik catatan yang tepat dari basis data terstruktur menggunakan identifier unik nomor CAS, bukan sekadar teks yang "mirip secara makna" — secara krusial mengubah kualitas jawaban: ia memutus ketergantungan pada kedekatan statistik dan menggantinya dengan kecocokan tabel yang presisi. Cara kerja teknis penautan ini dibahas lebih rinci dalam artikel Cara Membedah Komposisi INCI Kompetitor dengan AI.
Keterbatasan pendekatan RAG: di mana bahkan basis data terverifikasi tidak menyelamatkan dari kesalahan
Arsitektur RAG menutup masalah utama model bahasa — pembangkitan fakta dari "memori" tanpa bersandar pada sumber. Tetapi retrieval-augmented generation tidak mengubah sistem menjadi peramal. Ia memiliki serangkaian kelemahannya sendiri, dan sebagian di antaranya secara alami tidak bisa diperbaiki hanya dengan membersihkan basis data. Mari kita bahas di mana bahkan sumber pengetahuan yang sempurna sekalipun tidak menjamin jawaban yang benar.
Basis data yang usang: nomenklatur INCI dan regulasi memiliki dinamikanya sendiri
Basis data terverifikasi adalah cuplikan kondisi pengetahuan pada saat pengindeksan dilakukan. Nama INCI secara berkala direvisi oleh Personal Care Products Council, entri dalam basis rujukan diperbarui, dan pembatasan kadar baru muncul dalam peraturan nasional. Jika lapisan retrieval mengakses basis data yang tidak tersinkronisasi dengan registri terkini, sistem akan menghasilkan jawaban yang secara teknis "terkonfirmasi oleh sumber" — tetapi sumbernya sudah usang.
Untuk pasar Indonesia, contohnya tidak perlu dikarang. Peraturan BPOM Nomor 30 Tahun 2020 tentang Persyaratan Teknis Penandaan Kosmetika telah dicabut oleh Peraturan BPOM Nomor 18 Tahun 2024 tentang Penandaan, Promosi, dan Iklan Kosmetik. Peraturan BPOM Nomor 23 Tahun 2019 tentang Persyaratan Teknis Bahan Kosmetika telah dicabut oleh Peraturan BPOM Nomor 25 Tahun 2025. Sebuah indeks yang dibangun pada 2023 akan mengembalikan kutipan dari dua dokumen yang sudah tidak berlaku — lengkap dengan nomor pasal dan nada kepastian. Inilah bentuk kesalahan yang paling sulit dideteksi pengguna, karena semua penanda kredibilitas tampak hadir.
Kesalahan re-ranking: relevansi ≠ kebenaran
Setelah pencarian kandidat awal, re-ranker menyortir potongan berdasarkan relevansinya terhadap kueri — tetapi relevansi dan akurasi faktual untuk pertanyaan tertentu adalah metrik yang berbeda. Re-ranker yang dilatih pada embedding teks bisa saja memberi peringkat lebih tinggi pada dokumen yang secara leksikal mirip dengan kueri, tetapi mendeskripsikan bahan yang berdekatan, bukan bahan yang sebenarnya ditanyakan.
Skenario yang khas: kueri tentang Retinyl Palmitate, dengan diferensiasi embedding yang lemah, bisa menaikkan peringkat potongan tentang Retinol — senyawa yang secara kimia berkerabat tetapi berbeda dalam aktivitas dan toleransinya. Jika top-k dibatasi hingga tiga potongan dan dokumen yang sebenarnya dibutuhkan, tentang ester retinol, berada di posisi keempat, model generatif tidak akan melihatnya dan menyusun jawaban berdasarkan konteks yang berdekatan namun tidak akurat.
- Kedekatan semantik sinonim — kelas fungsional (emolien, pengemulsi) saling bertumpang tindih dalam ruang vektor, yang mengacaukan peringkat pada kueri yang tidak jelas.
- Potongan yang terlalu pendek — jika dokumen dipecah terlalu halus, konteks hilang (misalnya, dosis disebutkan di paragraf tetangga yang tidak masuk ke pemilihan top).
- Dominasi istilah yang sering muncul — bahan-bahan umum (misalnya, Glycerin) lebih sering muncul di puncak hasil re-ranking hanya karena volume penyebutannya yang besar dalam basis data, menyingkirkan kecocokan yang lebih jarang namun lebih tepat.
Cakupan yang tidak lengkap untuk bahan langka dan niche
Verifikasi basis data biasanya berfokus pada komponen INCI yang digunakan secara luas: pengawet, filter UV, bahan aktif yang umum. Peptida niche, ekstrak tumbuhan langka, atau turunan silikon yang sangat terspesialisasi sering hanya diwakili oleh sedikit dokumen — kadang hanya satu sumber, sering dalam bahasa Inggris, tanpa konfirmasi silang yang independen.
Masalah bahasa ini terukur. Tinjauan sistematis RAG di bidang kesehatan (PLOS Digital Health, 2025) mendapati bahwa 78,9% studi menggunakan dataset berbahasa Inggris dan 21,1% berbahasa Mandarin, tanpa korpus bahasa lain yang dilaporkan, serta menyimpulkan bahwa kerangka evaluasi yang terstandardisasi untuk aplikasi berbasis RAG masih belum ada. Untuk formulator Indonesia, dua temuan itu bergabung menjadi satu risiko praktis: bahan baku lokal, nama dagang lokal, dan dokumen regulasi berbahasa Indonesia adalah wilayah dengan kepadatan dokumen paling rendah dalam basis pengetahuan mana pun — justru di tempat Anda paling membutuhkan jawaban yang tepat.
Dalam kasus semacam ini, lapisan retrieval secara fisik tidak bisa memberikan rumusan alternatif kepada model generatif untuk dibandingkan. Sistem terpaksa bekerja dengan satu-satunya potongan yang ditemukan, dan jika potongan itu mengandung salah ketik pada persentase konsentrasi atau kelas fungsional yang salah — kesalahan tersebut langsung diteruskan ke jawaban tanpa sinyal ketidakpastian apa pun.
| Jenis bahan | Kepadatan dokumen dalam basis data | Risiko kesalahan retrieval |
|---|---|---|
| Pengawet dan emolien umum | Tinggi (puluhan sumber) | Rendah |
| Bahan aktif dengan sebaran menengah (Niacinamide, Sodium Ascorbyl Phosphate) | Sedang | Moderat |
| Peptida niche, ekstrak botani langka | Rendah (1–2 sumber) | Tinggi |
| Bahan baku lokal dan dokumen berbahasa Indonesia | Sangat rendah dalam korpus RAG yang dipublikasikan | Tinggi |
Kueri pengguna yang tidak jelas: retrieval bekerja dengan apa yang diberikan
Sistem RAG mengambil dokumen berdasarkan kueri — dan jika kueri dirumuskan secara tidak tepat atau menggunakan nama sehari-hari alih-alih INCI, kualitas retrieval turun secara proporsional. Kueri seperti "bahan pelembap yang mirip hyaluronic acid tapi lebih ringan" bisa mengarah pada pengambilan polisakarida bermassa molekul rendah, padahal pengguna sebenarnya bermaksud merujuk pada Sodium Hyaluronate tertentu dengan massa molekul spesifik.
Efek ini juga terlihat dalam studi whitelisting yang dikutip sebelumnya: pertanyaan faktual langsung dijawab jauh lebih baik daripada vinyet kasus yang harus ditafsirkan lebih dulu, dengan odds ratio 1,95 hingga 4,28 tergantung modelnya. Diterjemahkan ke pekerjaan kita: "berapa kadar maksimum phenoxyethanol menurut Peraturan BPOM 25/2025" adalah pertanyaan yang akan dijawab dengan baik; "apakah pengawet dalam formula saya cukup" adalah pertanyaan yang hampir pasti dijawab dengan kalimat umum, karena retrieval tidak punya dokumen tentang formula Anda. Ini bukan masalah basis data — ini adalah kesenjangan antara bahasa sehari-hari pengguna dan nomenklatur formal dari sumber-sumbernya.
Kesimpulan untuk praktik: pendekatan RAG yang dibangun di atas basis data terverifikasi adalah langkah maju yang signifikan dibandingkan menghasilkan jawaban "dari memori", tetapi bukan perlindungan mutlak. Sumber yang usang, kelemahan re-ranking, kelangkaan data untuk bahan langka dan untuk dokumen berbahasa Indonesia, serta sensitivitas terhadap rumusan kueri — semua faktor ini membutuhkan pengawasan manusia pada tahap akhir, terutama di tempat jawaban tersebut memengaruhi keamanan formula.
Kesimpulan praktis: cara memilih alat AI untuk menganalisis formula kosmetik
Pembahasan arsitektur, mekanisme halusinasi, dan titik-titik lemah pendekatan RAG membawa kita pada pertanyaan utama: bagaimana secara praktis membedakan alat yang bisa dipercaya untuk menganalisis komposisi INCI dari sekadar generator teks yang terdengar meyakinkan. Perbedaannya tidak sekadar soal merek atau janji pemasaran — perbedaan itu diperiksa berdasarkan kriteria teknis yang konkret.
Lima kriteria untuk memeriksa alat AI sebelum digunakan dalam pekerjaan
Sebelum mempercayakan analisis formula kepada jaringan saraf, pengembang kosmetik sebaiknya mengajukan lima pertanyaan kepada alat tersebut (atau penciptanya). Jawaban atas pertanyaan-pertanyaan ini menunjukkan apakah sistem tersebut bekerja berdasarkan prinsip retrieval-augmented generation atau sekadar generator murni tanpa verifikasi.
| Kriteria | Apa yang diperiksa | Tanda bahaya |
|---|---|---|
| Keberadaan lapisan RAG | Alat mencantumkan sumber untuk setiap pernyataan tentang konsentrasi, fungsi bahan | Jawaban tanpa rujukan ke catatan spesifik dalam basis data |
| Transparansi sumber | Ada akses ke daftar basis data yang digunakan (Peraturan BPOM, CIR, CosIng, technical data sheet, dan sejenisnya) | "Dilatih pada dataset besar" tanpa detail |
| Jenis dokumen dinyatakan | Setiap angka disertai keterangan: peraturan, laporan penilaian ahli, studi, atau technical data sheet pemasok | Semua angka disajikan dengan bobot yang sama |
| Keteraturan pembaruan basis data | Tanggal sinkronisasi terakhir dengan Peraturan BPOM yang berlaku (saat ini 25/2025 dan 18/2024) | Masih mengutip Peraturan BPOM 23/2019 atau 30/2020 |
| Pengakuan ketidakpastian | Model secara langsung mengatakan "data tidak cukup" ketika tidak ada catatan dalam basis data | Selalu memberikan jawaban percaya diri untuk pertanyaan apa pun |
Jika sebuah alat tidak bisa menjawab dengan jelas setidaknya dua dari lima poin tersebut, itu adalah sinyal untuk memperlakukan hasilnya hanya sebagai hipotesis kasar yang memerlukan verifikasi manual terhadap sumber primer.
Kapan ChatGPT tanpa RAG masih bisa diterima
Model generatif tanpa lapisan retrieval bukannya tidak berguna — model tersebut cocok untuk tugas-tugas di mana presisi angka tidak krusial: menghasilkan ide untuk teks pemasaran, kerangka kasar artikel, brainstorming nama produk. Masalah muncul ketika hasil model digunakan untuk mengambil keputusan yang berdampak pada keamanan dan stabilitas formula — menghitung % bahan aktif, menentukan kompatibilitas Retinol dengan asam AHA, menilai rentang stabilitas pH emulsi.
Rekomendasi praktis
Untuk tugas-tugas rutin — memeriksa kadar maksimum pengawet terhadap lampiran peraturan, mencari sinonim INCI, memverifikasi kelas fungsional bahan — alat berbasis RAG dengan basis data INCI terverifikasi mengurangi jumlah kesalahan secara terukur dibandingkan model generatif tanpa lapisan retrieval; besaran penurunannya pada domain kosmetik belum diukur dalam publikasi yang kami temukan, sehingga angka dari domain medis (8–18 poin persentase) hanya boleh dipakai sebagai indikasi arah, bukan sebagai janji. Ini juga tidak menghilangkan kebutuhan untuk membaca jawaban secara kritis: bahkan dengan arsitektur RAG, tetap perlu diperiksa sumber apa yang dirujuk sistem, dan tetap berhati-hati terhadap situasi-situasi yang dijelaskan di bagian keterbatasan pendekatan ini — catatan yang usang, sumber yang saling bertentangan, bahan langka tanpa cakupan basis data yang memadai.
Kriteria intinya sederhana: kepercayaan terhadap alat AI untuk menganalisis formula kosmetik harus tumbuh sebanding dengan transparansi sumbernya, bukan dengan seberapa meyakinkan nada jawabannya. Alat yang jujur mengatakan "saya tidak yakin, tidak ada data terkini tentang bahan ini dalam basis data" lebih berharga daripada alat yang dengan percaya diri menyebutkan konsentrasi yang tidak ada. Bagi para pengembang yang ingin memahami kimia formulasi secara sistematis sekaligus mempelajari cara bekerja dengan alat-alat semacam ini, ada baiknya memulai dengan kursus dasar analisis INCI dan formulasi — itulah fondasi pengetahuan yang memungkinkan seseorang membedakan jawaban AI yang benar dari halusinasi, bahkan tanpa memeriksa sumber primer.
Pertanyaan yang sering diajukan
Apakah RAG membuat jawaban AI menjadi 100% benar?
Tidak. Dalam studi banding 2025 di bidang neurologi, konfigurasi terbaik dengan pembatasan sumber berhenti pada 89% jawaban benar, naik dari 81% tanpa pembatasan. Kenaikannya nyata dan terukur, tetapi sisa kesalahan tetap ada dan harus ditangkap oleh pembacaan kritis manusia.
Bagaimana saya tahu basis data sebuah alat AI sudah usang?
Tanyakan satu pertanyaan yang jawabannya berubah: minta alat itu menyebutkan peraturan yang mengatur persyaratan teknis bahan kosmetik di Indonesia. Jika jawabannya Peraturan BPOM Nomor 23 Tahun 2019, indeksnya tertinggal — dokumen itu sudah dicabut oleh Peraturan BPOM Nomor 25 Tahun 2025.
Apakah angka dari technical data sheet pemasok bisa dipakai sebagai batas regulasi?
Tidak, keduanya jenis dokumen yang berbeda. Technical data sheet menyatakan kadar pakai yang direkomendasikan untuk satu bahan baku bermerek tertentu; kadar maksimum regulasi berlaku untuk zat tersebut dalam produk siap pakai apa pun. Sebuah bahan baku bisa direkomendasikan pada 2–6% sementara zat aktif di dalamnya tunduk pada batas terpisah.
Anda bisa melihat perbedaan ini pada tugas Anda sendiri di Klub Walker Formulation Academy: AI Chemist menjawab berdasarkan basis data INCI/CosIng yang terverifikasi, bukan berdasarkan "memori" model serba guna — ditambah pengajar langsung dan ulasan formulasi Anda.
Sumber
- Badan Pengawas Obat dan Makanan RI, Peraturan BPOM Nomor 25 Tahun 2025 tentang Persyaratan Teknis Bahan Kosmetik, 2025 — peraturan; sumber untuk batas phenoxyethanol 1,0%, methylisothiazolinone 0,0015% (sediaan bilas), kompleks aluminium zirconium 20%, dan status tretinoin.
- Badan Pengawas Obat dan Makanan RI, Peraturan BPOM Nomor 18 Tahun 2024 tentang Penandaan, Promosi, dan Iklan Kosmetik, 2024 — peraturan; sumber untuk kewajiban penggunaan nama INCI pada penandaan dan untuk pencabutan Peraturan BPOM Nomor 30 Tahun 2020.
- Evaluating Web Retrieval–Assisted Large Language Models With and Without Whitelisting for Evidence-Based Neurology, Journal of Medical Internet Research, 2025 — studi banding; sumber untuk kenaikan akurasi 8–18 poin persentase akibat pembatasan sumber.
- Amugongo dkk., Retrieval augmented generation for large language models in healthcare: A systematic review, PLOS Digital Health, 2025 — tinjauan sistematis; sumber untuk 78,9% / 21,1% sebaran bahasa dataset dan untuk ketiadaan kerangka evaluasi standar.
- Ge dkk., Development of a liver disease-specific large language model chat interface using retrieval-augmented generation, Hepatology, 2024 — studi pengembangan dan evaluasi; sumber untuk hasil 10 dari 10 dan untuk pertukaran akurasi–kelengkapan.
- Willhite dkk., Systematic review of potential health risks posed by exposures to aluminum, Critical Reviews in Toxicology, 2014 — tinjauan sistematis; sumber untuk pembahasan hipotesis aluminium–Alzheimer.
- Nicotinamide: A Multifaceted Molecule in Skin Health and Beyond, Medicina, 2025 — tinjauan naratif; sumber untuk mekanisme niacinamide tanpa penetapan konsentrasi topikal optimal.
- The first step is the hardest: pitfalls of representing and tokenizing temporal data for large language models, JAMIA, 2024 — analisis metodologis; sumber untuk masalah representasi angka pada LLM.
- Ambiguity in medical concept normalization: An analysis of types and coverage in electronic health record datasets, JAMIA, 2021 — analisis himpunan data; sumber untuk kontras <15% versus >50% ambiguitas.
- European Commission, CosIng — Cosmetic Ingredient Database — basis data rujukan nomenklatur dan identitas zat (bukan regulator Indonesia).
- Cosmetic Ingredient Review (CIR), Ingredient Reports — laporan penilaian ahli independen atas kondisi penggunaan yang ditinjau.
- Austria R., Semenzato A., Bettero A., "Stability of vitamin C derivatives in solution and topical formulations", Journal of Pharmaceutical and Biomedical Analysis, 1997 (PMID 9172105) — studi analitik; dikutip tanpa tautan karena halaman penerbit tidak dapat kami buka dari jaringan redaksi.
- Ji Z. dkk., "Survey of Hallucination in Natural Language Generation", ACM Computing Surveys, 2023 — survei literatur; dikutip tanpa tautan karena berada di luar daftar sumber yang kami verifikasi secara langsung.
- Lewis P. dkk., "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks", NeurIPS, 2020 — makalah arsitektur; dikutip tanpa tautan dengan alasan yang sama.