Mengapa Perlu Menganalisis Daftar INCI Kompetitor, dan Bagaimana AI Membantu
Setiap botol yang berjejer di rak ritel massal atau di butik niche adalah lebih dari sekadar pemasaran dan kemasan — itu adalah formula yang terenkripsi, tersedia secara terbuka bagi siapa saja dalam bentuk daftar INCI (International Nomenclature of Cosmetic Ingredients). Daftar pada label itu adalah satu-satunya sumber legal yang bisa digunakan seorang pengembang untuk mengekstrak struktur formula orang lain tanpa akses ke dokumentasi laboratorium. Menganalisis komposisi kompetitor sudah lama bukan lagi kegiatan khusus para analis paten — kini itu menjadi tugas rutin bagi brand manager, spesialis R&D, dan ahli kimia kosmetik yang ingin memahami pasar lebih cepat daripada yang bisa dicapai lewat kerja manual selama berminggu-minggu.
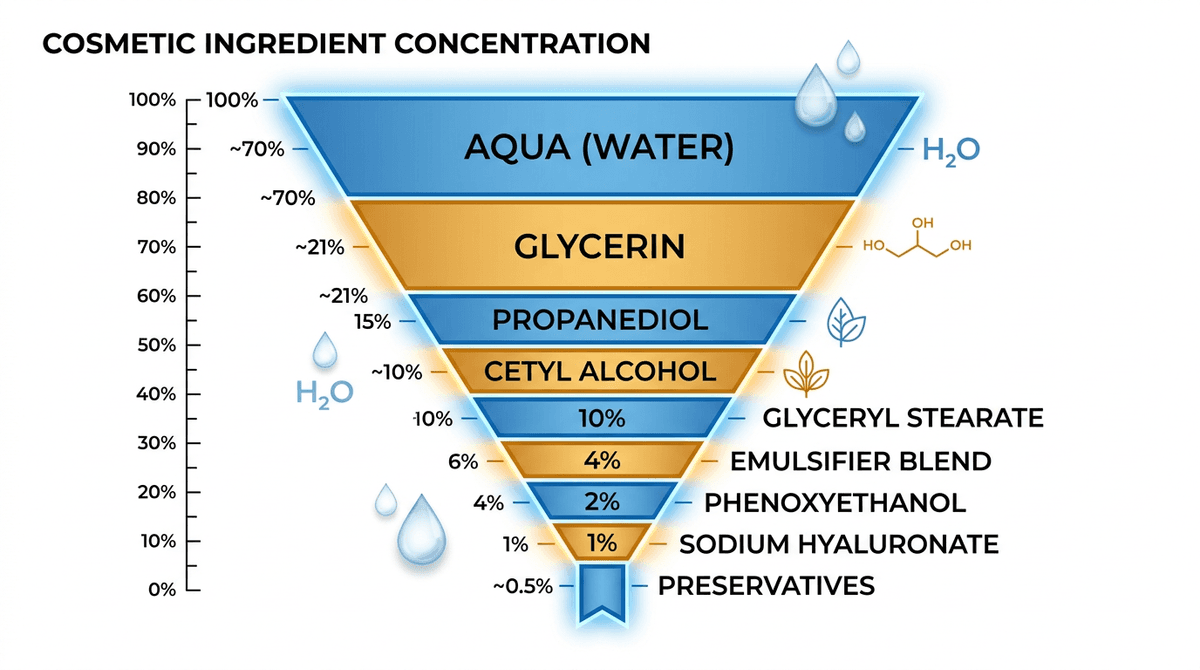
Daftar INCI mengikuti aturan yang ketat: bahan-bahan dicantumkan berdasarkan urutan konsentrasi menurun, sementara komponen dengan kadar di bawah 1% bisa dicantumkan dalam urutan apa saja. Aturan ini sekaligus menjadi petunjuk dan jebakan — ia memberi kita kerangka formula, tetapi bukan angka pastinya. Karena itulah tantangan utama dalam analisis manual: seorang spesialis melihat urutannya, tetapi harus merekonstruksi kisaran konsentrasi yang masuk akal berdasarkan batas regulasi, peran fungsional masing-masing bahan, dan praktik formulasi yang umum.
Masalah Apa yang Dipecahkan oleh Analisis Komposisi Kompetitor
Mempelajari formula milik pihak lain jarang dilakukan sekadar karena rasa ingin tahu. Dalam praktiknya, hal ini melayani beberapa tujuan bisnis dan R&D yang konkret:
- Benchmarking formula — membandingkan resep milik sendiri dengan produk-produk terbaik di kategori tersebut dari segi jenis basis, bahan aktif, dan bahan pendukung.
- Menemukan titik lemah produk — mengidentifikasi pengawet yang sudah usang, kandungan silikon yang berlebihan, atau bahan aktif yang diklaim di kemasan tetapi sebenarnya tidak ada pada konsentrasi yang efektif.
- Membedah tekstur acuan — memahami sistem emulsifier dan modifier reologi mana yang menciptakan konsistensi khas dari sebuah produk terlaris.
- Memeriksa klaim pemasaran — apakah positioning "dengan retinol" sesuai dengan posisi sebenarnya bahan tersebut dalam daftar, atau hanya dosis simbolis di sekitar 0,01%.
- Merencanakan diferensiasi — menemukan ceruk formulasi yang belum tergarap saat seluruh segmen mengandalkan set humektan yang sama, tiga atau empat jenis saja.
Tugas-tugas ini dulu dikerjakan secara manual: seorang ahli kimia membuka label, memeriksa setiap bahan lewat referensi INCI Decoder atau CosIng, memperkirakan kelompok fungsionalnya, dan mencatat hipotesis dalam spreadsheet. Proses ini bisa memakan waktu antara tiga puluh menit hingga beberapa jam per produk — dan kualitas hasilnya sangat bergantung pada pengalaman spesialis yang mengerjakannya.
Peran Analisis AI dalam Membedah Formula
Analisis AI terhadap daftar bahan tidak menggantikan keahlian kimia, tetapi secara drastis mempercepat pengolahan data awal. Model bahasa yang dilatih dengan basis data regulasi dan terminologi formulasi dapat, dalam hitungan detik:
- Mengidentifikasi peran fungsional setiap bahan dalam daftar (emulsifier, pengawet, humektan, antioksidan, dan sebagainya);
- Mengelompokkan bahan berdasarkan fase emulsi — fase air, fase minyak, dan fase aktif;
- Memperkirakan kisaran konsentrasi yang masuk akal berdasarkan posisi dalam daftar dan batas regulasi yang diketahui (mengacu pada riset formulasi yang direproduksi oleh Draelos, 2015, serta kajian-kajian lanjutan mengenai praktik formulasi);
- Menandai kombinasi yang berpotensi bermasalah — misalnya, ketidakcocokan pengawet tertentu dengan pH tinggi.
Analisis AI semacam ini terhadap daftar INCI kompetitor mengubah rangkaian huruf statis pada label menjadi hipotesis terstruktur tentang formulanya: arsitektur perkiraan, distribusi fase, serta asumsi mengenai konsentrasi bahan aktif utama. Seorang spesialis kemudian memverifikasi dan mengoreksi hipotesis tersebut — AI menghasilkan draf, bukan keputusan final.
Pada bagian-bagian selanjutnya, kita akan membahas bagaimana proses ini bekerja — dari menyiapkan daftar INCI hingga menyusun prompt untuk AI dan menafsirkan laporan yang dihasilkan — serta menelusuri seluruh langkahnya secara bertahap menggunakan contoh yang konkret.
Apa Itu INCI, dan Mengapa Bukan Sekadar Daftar Bahan
INCI (International Nomenclature of Cosmetic Ingredients) adalah sistem penamaan terpadu untuk bahan baku, yang diadopsi untuk pelabelan produk kosmetik. Setiap nama dalam nomenklatur ini terkait dengan struktur kimia atau sumber botani tertentu dan tidak bergantung pada nama dagang produsen. Artinya, Glycerin pada kemasan merek asal Prancis dan Glycerin pada kemasan merek asal Korea secara molekuler identik, terlepas dari sebutan apa pun yang digunakan materi pemasaran. Namun justru standardisasi nama semacam ini yang mengubah daftar bahan menjadi teks berkode: tanpa memahami aturan urutan dan nilai ambang batasnya, daftar ini mudah salah dibaca — kadang bahkan terbalik sepenuhnya.
Prinsip Konsentrasi Menurun
Aturan kunci INCI adalah bahwa komponen dicantumkan berdasarkan urutan konsentrasi menurun — tetapi hanya sampai titik tertentu. Berdasarkan Peraturan BPOM No. 25 Tahun 2025 Eropa, yang mengatur pelabelan kosmetik di seluruh UE, bahan-bahan dengan kadar di atas 1% harus dicantumkan secara ketat sesuai urutan menurun berdasarkan fraksi massa. Artinya, 3–5 posisi pertama dalam daftar hampir selalu merupakan basis dari formula: air, emolien, emulsifier, humektan. Jika Aqua tercantum pertama dan posisi berikutnya adalah Glycerin, pengembang sebenarnya sudah memberi tahu kita perkiraan rasio antara fase air dan fase gliserin — tanpa satu pun angka di label.
Ambang Batas Tersembunyi: Apa yang Terjadi di Bawah 1%
Begitu konsentrasi suatu komponen turun di bawah 1%, aturan urutan ketat tidak lagi berlaku. Peraturan BPOM No. 25 Tahun 2025 mengizinkan produsen mencantumkan bahan-bahan tersebut dalam urutan apa pun — ini mencakup pengawet, pewangi, pewarna, dan bahan aktif dosis rendah (peptida, ekstrak, vitamin). Inilah sebabnya kompleks peptida yang mahal sering ditempatkan tepat di sebelah pewarna biasa seperti CI 19140 di bagian paling akhir daftar — dari posisinya saja, tidak ada cara untuk mengetahui apakah yang satu berada di 0,9% dan yang lain di 0,01%.
Hal ini sangat penting saat menganalisis formula kompetitor: jika alat AI atau analis manusia menganggap "sepertiga bawah" daftar sebagai tidak penting, mudah sekali terlewatkan bahan aktif yang sengaja ditempatkan produsen di bawah ambang 1% untuk menghindari pengungkapan konsentrasi dan peran sebenarnya dalam formula.
Nama-nama Penyamar: Parfum, Aqua, dan Istilah Payung
Nomenklatur INCI memperbolehkan penyebutan yang disebut istilah "payung", yang menyembunyikan puluhan zat kimia di balik satu kata saja:
- Parfum / Fragrance — bisa mencakup 50–200 komponen aromatik individual, yang beberapa di antaranya merupakan alergen potensial, dan hanya wajib dicantumkan secara terpisah di atas ambang tertentu (di UE, 26 alergen bernama wajib dilabeli secara individual jika di atas 0,001% pada produk yang tidak dibilas dan 0,01% pada produk yang dibilas).
- Aqua / Water — secara formal hanya satu molekul, tetapi fase air yang sesungguhnya pada produk premium sering mengandung air termal, air misel, atau air terdistilasi dengan profil mineral yang berbeda — semuanya tidak tercermin dalam namanya.
- Istilah payung seperti Parfum memungkinkan formula wewangian dilindungi sebagai rahasia dagang — regulasi mengizinkan penyembunyian komposisi pasti campuran aroma, dengan alasan melindungi hak kekayaan intelektual sang perfumer.
Ketidaktransparanan ini bukan celah hukum — melainkan kompromi yang disengaja antara hak konsumen atas informasi dan perlindungan formula kepemilikan. Kerangka regulasinya diuraikan secara rinci dalam teks Regulasi (EC) No 1223/2009 Parlemen Eropa sebagai referensi internasional, dan sistematisasi aturan nomenklatur beserta perkembangan historisnya dibahas dalam literatur regulasi kosmetik (menurut Rathi, 2011; uraian serupa mengenai arsitektur nomenklatur INCI muncul pula dalam Bilal & Iqbal, 2020).
Mengapa Hal Ini Mengubah Pendekatan Analisis
Ketika AI mengurai daftar INCI kompetitor, ia perlu memperhitungkan tidak hanya urutan kata tetapi juga aturan strukturalnya: di mana zona "di atas 1%" berakhir, istilah mana yang menyembunyikan campuran kompleks, dan posisi mana menjelang akhir daftar yang justru bisa jadi merupakan bahan aktif mahal, bukan sekadar "residu jejak." Tanpa konteks tersebut, model akan menafsirkan daftar secara linear — seolah posisi #15 otomatis kurang signifikan dibanding posisi #5, padahal itu tidak selalu berlaku pada formula dunia nyata.
Bagaimana AI 'Membaca' Struktur Kimia dari Sebuah Komposisi: Mekanisme Parsing NLP untuk INCI
Rangkaian INCI pada label bukanlah teks koheren dengan tata bahasa — melainkan daftar datar berisi token yang dipisahkan koma, di mana urutannya mengkodekan konsentrasi, bukan logika naratif. Bagi model bahasa, ini adalah tugas yang tidak biasa: pipeline NLP standar dilatih dengan ucapan alami yang memiliki relasi sintaksis, sementara daftar bahan sebuah krim lebih menyerupai katalog nomenklatur, yang secara struktural lebih dekat dengan basis data kimia dibanding prosa. Itulah sebabnya mengurai INCI membutuhkan rangkaian pemrosesan khusus, bukan sekadar chatbot serba guna.
Tokenisasi dan Named Entity Recognition (NER)
Tahap pertama adalah Named Entity Recognition (NER), yang disesuaikan untuk domain kimia. Model membagi rangkaian menjadi token kandidat dan mengklasifikasikan masing-masing sebagai kemungkinan nama bahan, bahkan ketika terdiri dari beberapa kata (Sodium Ascorbyl Phosphate adalah satu entitas, bukan tiga). Kesulitannya adalah nomenklatur INCI menggunakan nama botani Latin, singkatan dagang, indeks numerik (PEG-100 Stearate), serta konstruksi gabungan yang menggunakan tanda hubung atau kurung — tokenizer standar yang dilatih dengan korpus berita seringkali salah memisahkan istilah-istilah semacam ini.
Untuk meningkatkan akurasi, digunakan model yang disesuaikan untuk domain khusus seperti BioBERT atau ChemBERTa, yang di-fine-tune dengan teks kimia dan biomedis — embedding-nya menangkap pola nomenklatur kimia lebih baik daripada model serba guna (menurut Beltagy dkk., 2019, dalam konteks SciBERT untuk teks ilmiah). Aturan regex juga diterapkan untuk menangkap sufiks numerik (-100, -20) dan pola mirip CAS, yang mengurangi kesalahan positif pada token yang tidak dikenal.
Pencocokan dengan Basis Data: Dari String Menjadi Struktur
Setelah tokenisasi, setiap entitas yang teridentifikasi melewati tahap entity linking — pencocokan dengan basis data referensi. Beberapa sumber digunakan secara bersamaan di sini:
- CosIng (Cosmetic Ingredient Database) — basis data resmi UE, yang berisi nama INCI, nomor CAS, kelas fungsional, dan batasan regulasi.
- PubChem — basis data senyawa kimia dengan struktur molekuler, yang memungkinkan model menghubungkan nama INCI dengan notasi SMILES tertentu serta sifat fisikokimianya.
- Kamus sinonim internal, karena satu bahan yang sama dapat muncul dengan nama dagang berbeda dari pemasok yang berbeda.
Secara teknis, pencocokan ini diimplementasikan melalui kesamaan vektor dari embedding (cosine similarity) antara token yang teridentifikasi dan entri basis data, bukan melalui pencocokan teks yang tepat — ini penting karena label sesungguhnya sering mengandung kesalahan ketik, penggunaan huruf kapital yang tidak konsisten, dan variasi penulisan (Tocopherol vs Tocopheryl Acetate adalah zat yang berbeda dan mudah tertukar bila hanya dibandingkan secara permukaan sebagai string). Pendekatan fuzzy-matching berbasis embedding semacam ini dijelaskan dalam riset entity-linking untuk istilah biomedis (Wang dkk., 2021, dalam konteks menghubungkan entitas medis ke UMLS).
Pengelompokan Berdasarkan Kelas Fungsional
Langkah terakhir adalah memberikan setiap bahan yang teridentifikasi sebuah tag fungsional: emolien, surfaktan, pengawet, chelator, antioksidan, dan sebagainya. Ini bukan sekadar pencarian di tabel CosIng (meskipun basis data tersebut memiliki kolom fungsi) — ini seringkali merupakan tugas klasifikasi multi-kelas, karena satu bahan bisa memiliki beberapa peran sekaligus. Glycerin berfungsi sebagai humektan, pelarut, dan pada konsentrasi tinggi, penguat pengawet; model harus mempertimbangkan konteks (posisi dalam daftar, bahan-bahan tetangganya) untuk menentukan fungsi dominan dalam formula tertentu.
| Tahap pemrosesan | Metode | Sumber data |
|---|---|---|
| Tokenisasi | Regex + aturan domain | Kamus pola-INCI internal |
| NER | Model mirip BERT (BioBERT, ChemBERTa) | Fine-tuning pada korpus kimia |
| Entity linking | Cosine similarity dari embedding | CosIng, PubChem |
| Pengelompokan | Klasifikasi multi-kelas | Tag fungsional CosIng + konteks posisi |
Arsitektur multi-tahap ini menjelaskan mengapa breakdown INCI yang baik dari AI tidak hanya menghasilkan daftar "apa itu zat ini," tetapi sebuah peta peran fungsional setiap komponen dalam formula — itulah yang justru mengubah daftar mentah menjadi alat analisis. Untuk penjelasan lebih lanjut tentang bagaimana kelompok fungsional ini berubah menjadi formula jadi, lihat artikel kami tentang reformulasi kosmetik dari daftar INCI kompetitor.
Algoritma Langkah demi Langkah: Dari Mengambil Komposisi Kompetitor Hingga Laporan AI Jadi
Membedah daftar INCI terdiri dari lima langkah teknis, dan masing-masing memengaruhi kualitas laporan akhir. Melewatkan satu langkah pun — misalnya, langsung memakai teks mentah yang belum diolah dari kemasan — hanya akan memberi AI data "kotor," dan hasilnya berupa kumpulan kalimat generik, bukan analisis yang konkret.
Langkah 1. Mengumpulkan Teks Komposisi Sumber
Komposisi kompetitor bisa diambil dari tiga sumber: listing produk di marketplace, situs resmi brand, atau foto label. Prioritaskan situs resmi produsen — teksnya biasanya sudah diperiksa dan tidak terkena kesalahan copy-paste. Listing di marketplace sering mengandung typo dari penjual (tanda hubung yang hilang, kata yang menyatu, karakter Sirilik yang tertukar dengan Latin), yang sangat berpengaruh pada proses parsing.
- Situs brand — salin teks langsung dari blok HTML komposisi, hindari tangkapan layar.
- Marketplace — cocokkan dengan foto kemasan jika komposisi yang tercantum kurang dari 15 bahan (tanda deskripsi yang terpotong).
- Foto label — kenali lewat OCR (Google Lens, Adobe Scan) dan selalu periksa ulang hasilnya secara manual: OCR sering menukar Cetearyl Alcohol dengan Cetyl Alcohol, huruf "I" dengan "l," dan "O" dengan "0."
Langkah 2. Menormalkan Teks
Sebelum dikirim ke model, komposisi dirapikan ke format yang konsisten:
- Pisahkan bahan dengan koma, hapus titik koma dan baris baru di dalam satu nama.
- Samakan penggunaan huruf besar/kecil secara keseluruhan — tidak krusial untuk makna, tetapi mengurangi risiko model "tidak mengenali" nama karena semuanya huruf kapital.
- Buang catatan kaki dan anotasi marketing seperti "*bahan organik" yang terkadang disisipkan langsung ke dalam daftar INCI.
- Periksa urutannya — menurut regulasi, INCI diurutkan menurun berdasarkan konsentrasi hingga 1%, setelah itu urutannya bebas. Ini lebih relevan untuk interpretasi daripada normalisasi, tetapi tetap perlu dicatat pada langkah ini juga.
Hasilnya adalah string yang bersih seperti: Aqua, Glycerin, Niacinamide, Butylene Glycol, Sodium Hyaluronate, Panthenol, Phenoxyethanol, Ethylhexylglycerin.
Langkah 3. Menulis Prompt
Prompt menentukan kedalaman dan struktur laporan. Permintaan yang lemah ("ceritakan tentang komposisi ini") akan menghasilkan rangkuman fungsi bahan yang generik, yang bisa ditemukan di database mana pun. Prompt yang efektif menetapkan peran, struktur output, dan kriteria analisis.
Struktur prompt yang solid dibangun dari empat blok:
| Blok prompt | Isi |
|---|---|
| Peran | "Anda adalah seorang ahli kimia formulasi kosmetik yang berpengalaman dalam melakukan reverse-engineering daftar bahan" |
| Data input | Daftar INCI yang sudah dinormalkan + kategori produk (serum, krim, emulsi) |
| Tugas | Menentukan jenis formula (emulsi/gel/anhidrat), bahan aktif dan perkiraan konsentrasinya, sistem pengawet, serta titik-titik lemah |
| Format output | Tabel "bahan — fungsi — posisi dalam daftar — perkiraan %," plus blok terpisah berisi kesimpulan soal stabilitas dan biaya |
Contoh prompt yang berfungsi baik: "Analisis komposisi INCI ini sebagai seorang ahli kimia formulasi. Produknya adalah serum pelembap. Tentukan: 1) jenis sistem basisnya, 2) tiga bahan aktif utama dan perkiraan konsentrasinya berdasarkan posisi dalam daftar, 3) komposisi sistem pengawet, 4) potensi masalah stabilitas atau kompatibilitas. Sajikan dalam bentuk tabel, lalu tambahkan kesimpulan tertulis sepanjang 5–7 kalimat."
Langkah 4. Interpretasi Awal terhadap Output
AI menghasilkan hipotesis, bukan fakta — ingat ini saat membaca laporannya. Berikut pemeriksaan kewajaran yang baik untuk output tersebut:
- Jumlah perkiraan persentase bahan aktif tidak boleh melebihi 100%, dan secara logis harus sejalan dengan posisi bahan tersebut dalam daftar.
- Konsentrasi pengawet yang disebutkan harus berada dalam batas regulasi — misalnya, Phenoxyethanol dibatasi maksimal 1% menurut aturan UE.
- Jika model menyebut bahan yang berada mendekati akhir daftar (melewati posisi 15) sebagai "bahan aktif utama dengan konsentrasi tinggi," itu adalah kesalahan pembacaan urutan INCI, dan kesimpulannya perlu dikoreksi secara manual.
Langkah 5. Menyusun Laporan
Laporan akhir disusun dari tiga bagian: tabel rincian bahan (dari langkah 3), kesimpulan tertulis dari model (yang sudah diperiksa manual sesuai langkah 4), dan komentar dari ahli kimia sendiri — perbandingan dengan formula acuan, perkiraan biaya, asumsi tentang positioning produk. Bagian ketiga inilah yang mengubah output AI dari analisis generik menjadi laporan kompetitif yang bisa langsung dipakai sebagai briefing proyek formulasi.
Menguraikan Peran Fungsional: Apa yang Ada di Balik Setiap Bahan
Setelah AI mengenali token-token INCI satu per satu, tugas yang lebih sulit pun dimulai: mencari tahu mengapa setiap komponen ada dalam formula tersebut. Nama bahan saja tidak memberi tahu fungsinya: Cetearyl Alcohol bisa berperan sebagai emulsifier atau structurant, sementara Citric Acid bisa menjadi chelator, pengatur pH, dan eksfoliator ringan sekaligus. AI menyelesaikan ambiguitas ini dengan mengaitkan struktur molekul dengan parameter fisikokimia — polaritas, nilai HLB (Hydrophilic-Lipophilic Balance), dan keberadaan gugus fungsional yang mampu melakukan kompleksasi atau reaksi redoks.
Dari Struktur ke Fungsi: Tiga Parameter yang Dihitung Model
Untuk setiap bahan yang berhasil dikenali, model mengacu pada database deskriptor molekul — berat atom, panjang rantai hidrokarbon, jumlah gugus hidroksil dan karboksil, keberadaan cincin aromatik. Data ini memungkinkannya memperkirakan logaritma koefisien partisi (logP), yang berkorelasi dengan HLB dan memprediksi bagaimana molekul berperilaku di antarmuka fase (mengikuti pendekatan yang dijelaskan dalam Griffin, 1954, dan dikembangkan lebih jauh dalam pemodelan QSAR untuk surfaktan kosmetik — Klein et al., 2019).
| Parameter | Apa yang ditunjukkan | Contoh bahan | Kesimpulan fungsional AI |
|---|---|---|---|
| HLB 3-6 | keseimbangan lipofilik | Glyceryl Stearate | emulsifier W/O |
| HLB 10-18 | keseimbangan hidrofilik | Polysorbate 20 | emulsifier O/W, solubilizer |
| logP < 0 | polaritas tinggi | Sodium Ascorbyl Phosphate | antioksidan, fase air |
| keberadaan gugus karboksil + bobot molar rendah | kemampuan mengikat logam (chelating) | Disodium EDTA | chelator, penstabil |
Emulsifier dan Keseimbangan HLB: Bagaimana AI Menentukan Jenis Sistem
Ketika model melihat sekelompok bahan dengan nilai HLB yang berbeda-beda, ia tidak sekadar merekonstruksi daftar, tetapi juga logika di balik sistem emulsinya. Misalnya, kombinasi Cetearyl Alcohol (HLB≈4, co-emulsifier) dan Ceteareth-20 (HLB≈15,5) adalah pola khas emulsi O/W dengan suhu kerja fase 70-75°C — AI mengenali pola ini sebagai "sistem emulsifikasi biner klasik" dan mencocokkannya dengan template formulasi khas industri (lihat juga ulasan kami tentang emulsifier dalam artikel soal memilih emulsifier). Jika komposisinya mengandung hidrokoloid seperti Xanthan Gum bersama hanya sebagian kecil emulsifier sungguhan, model menyimpulkan bahwa stabilisasi berasal dari peningkatan viskositas, bukan interaksi surfaktan klasik — ini adalah dua pendekatan yang mendasarnya berbeda dalam reverse-engineering tekstur.
Mengenali Chelator dan Antioksidan Lewat Gugus Fungsional
Chelator dikenali dari keberadaan beberapa gugus karboksil atau fosfonat yang mampu membentuk ikatan koordinasi dengan ion Fe³⁺ dan Cu²⁺ — persis logam-logam yang mengkatalisis oksidasi lipid dan degradasi vitamin dalam sebuah formula (Fessi & Puisieux, 2001, dalam konteks stabilitas emulsi). Antioksidan dikenali dengan cara berbeda: model mencari gugus hidroksil aromatik (fenol) atau struktur ester-fosfat redoks-aktif dari asam askorbat. Jadi Tocopherol dan Sodium Ascorbyl Phosphate memang tidak serupa dari namanya, tetapi secara struktural keduanya sama-sama memiliki kemampuan menyumbangkan elektron, yang oleh AI ditandai dengan satu label yang sama — "antioksidan primer" — terlepas dari kelarutannya.
Mengapa Ini Penting untuk Reverse-Engineering Formula
Menentukan fungsi, bukan sekadar mengenali nama, adalah hal yang mengubah daftar INCI menjadi peta formula yang bisa digunakan. Memahami bahwa suatu bahan adalah chelator, bukan sekadar "bahan tambahan tekstur," memberi tahu Anda mengapa bahan itu diletakkan tepat setelah air dan glycerin (urutan INCI berkorelasi dengan konsentrasi massa, kecuali di bawah 1%, di mana urutannya bebas — sebuah aturan regulasi yang ditetapkan dalam Peraturan BPOM No. 25 Tahun 2025). Dengan begitu, Anda bisa merekonstruksi bukan hanya komposisinya, tetapi juga logika prosesnya: rentang suhu untuk penambahan fase, urutan penambahan bahan aktif, kisaran pH yang diharapkan dari sistem jadi — semua yang dibutuhkan untuk mereproduksi formula kompetitor secara cermat, bukan sekadar menyalin secara mekanis.
Kesalahan Umum dalam Analisis AI terhadap Komposisi Kompetitor, dan Cara Menghindarinya
AI menghasilkan laporan komposisi yang tersusun rapi dengan cepat, dan justru kecepatan itulah yang menciptakan rasa percaya yang keliru. Dalam praktiknya, bahkan model yang bagus pun kerap tersandung di tiga area: salah membaca urutan bahan, mengarang detail untuk nama yang tidak dikenal, dan mengacaukan sinonim INCI. Mari kita bahas satu per satu jebakan ini, lengkap dengan contoh konkret di mana AI biasanya salah langkah.
Kesalahan 1: Membaca Urutan Bahan secara Harfiah sebagai Konsentrasi Pasti
Regulasi hanya mewajibkan urutan menurun hingga ambang 1%; setelah itu, urutannya bisa bebas (biasanya alfabetis). AI, terutama dengan prompt yang kurang detail, cenderung memperlakukan seluruh string sebagai hierarki ketat dari tertinggi ke terendah — sehingga pengawet yang berada di antara ekstrak tumbuhan dalam daftar secara default dijelaskan sebagai "hadir dalam konsentrasi yang signifikan," padahal sebenarnya hanya sepersekian persen.
Kesalahan 2: Halusinasi pada Nama INCI yang Tidak Dikenal atau Jarang Ditemui
Ketika model menemukan nama INCI yang tidak standar, sudah usang, atau bersifat regional (misalnya, ekstrak tumbuhan lokal yang hanya terdaftar dalam nomenklatur Asia), model kadang tidak berterus terang mengatakan "saya tidak tahu" — melainkan menghasilkan deskripsi fungsi dan asal-usul yang kedengarannya masuk akal tetapi sebenarnya dikarang. Ini adalah halusinasi klasik LLM: model mengisi kekosongan dengan sesuatu yang secara statistik masuk akal, bukan fakta yang terverifikasi.
| Tanda halusinasi | Cara memeriksanya |
|---|---|
| Deskripsi yang terlalu umum ("bahan pelembap berbasis tumbuhan") | Cocokkan secara manual dengan CosIng atau INCI Dictionary |
| Tidak ada fungsi spesifik yang diberikan (antioksidan/emolien/surfaktan) | Tanyakan pada AI sumber klasifikasinya dan minta ia menandai ketidakpastian |
| Nama tidak ditemukan dalam database terbuka | Periksa ejaannya — sering kali ini kesalahan transliterasi atau typo dalam komposisi sumber |
Aturan praktis: setiap bahan yang tidak bisa diberi peran fungsional spesifik dan kisaran dosis lazim oleh model perlu diverifikasi secara manual — jangan masukkan ke dalam kesimpulan akhir laporan sebagai fakta yang sudah pasti.
Kesalahan 3: Mengacaukan Sinonim INCI dan Nama Dagang
Zat yang sama bisa muncul dengan nama INCI berbeda-beda tergantung pemasok bahan bakunya, sementara istilah dagang sehari-hari (seperti "hyaluronic" atau "vitamin C") menyembunyikan lusinan derivat yang berbeda secara kimiawi dengan stabilitas dan bioavailabilitas yang berbeda pula. AI kadang mengacaukan Sodium Hyaluronate dengan Hydrolyzed Hyaluronic Acid, atau menyamakan semua derivat asam askorbat di bawah satu label "vitamin C" tanpa membedakan Ascorbic Acid, Sodium Ascorbyl Phosphate, dan Ascorbyl Glucoside — padahal ketiganya punya stabilitas penyimpanan dan pH optimal yang sangat berbeda.
- Selalu minta AI memberikan nama INCI lengkap yang tepat, bukan kategori umum ("ini bentuk vitamin C, tetapi yang mana secara spesifik?")
- Minta model menjelaskan secara eksplisit perbedaan antara nama-nama yang serupa ketika komposisi mengandung beberapa derivat dari bahan aktif yang sama
- Jangan langsung percaya kesimpulan bahwa dua komposisi "identik" hanya karena kategori bahan umumnya cocok — periksa string INCI-nya secara nyata
Cara Meminimalkan Risiko Kesalahan dalam Praktik
Tiga langkah berikut menurunkan tingkat kesalahan ke level yang bisa diterima:
- Pemeriksaan ganda — verifikasi secara manual setiap kesimpulan tentang "bahan aktif pada konsentrasi kerja" dengan database terbuka (CosIng, PubChem), terutama jika kesimpulan itu memengaruhi keputusan formulasi
- Instruksi prompt yang eksplisit — minta model sejak awal untuk menandai jawaban yang tidak pasti dengan "data tidak cukup" alih-alih menghasilkan teks yang sekadar kedengarannya masuk akal
- Cross-check dengan query kedua — ajukan pertanyaan yang sama dengan kata-kata berbeda, atau jalankan lewat model lain, lalu bandingkan jawabannya; perbedaan hasil adalah sinyal untuk ditinjau ulang secara manual
Analisis AI terhadap INCI adalah akselerator untuk tinjauan awal, bukan pengganti keahlian kimiawi. Laporan AI sebaiknya dianggap sebagai kumpulan hipotesis awal yang masih perlu dikonfirmasi sebelum digunakan untuk mengembangkan formula Anda sendiri.
Dari Analisis ke Aksi: Menggunakan Insight AI dalam Pengembangan Formula Anda Sendiri
Laporan AI bukanlah produk jadi — ia adalah bahan mentah untuk pengambilan keputusan. Perbedaan antara formulator hobi dan profesional adalah: yang pertama meniru komposisi kompetitor hampir kata demi kata, sementara yang kedua mengekstrak pola dari analisis dan menerjemahkannya ke dalam logika formulanya sendiri — dengan rasio berbeda, biaya berbeda, dan set klaim yang berbeda. Mari kita bahas persisnya bagaimana mengubah data parsing yang kering menjadi keputusan yang bisa dieksekusi.
Benchmarking: Menemukan Kesenjangan Antara Klaim dan Realitas
Hal pertama yang diberikan oleh data analisis AI yang terstruktur adalah kemampuan untuk membandingkan beberapa komposisi kompetitor secara berdampingan. Jika Anda sudah menjalankan 5–7 produk dari kategori yang sama melalui AI (misalnya, serum dengan Niacinamide), Anda akan mendapatkan statistik tentang posisi bahan aktif dalam daftar INCI — yang berkorelasi langsung dengan konsentrasinya.
| Merek | Posisi Niacinamide dalam INCI | Estimasi konsentrasi | Klaim yang dinyatakan |
|---|---|---|---|
| Kompetitor A | ke-4 | 8–10% | "Meratakan warna kulit" |
| Kompetitor B | ke-9 | 2–3% | "Dengan niacinamide" |
| Kompetitor C | ke-3 | 10–12% | "Anti-pigmentasi" |
Tabel seperti ini langsung mengungkap kesenjangannya: Merek B menjual pemasaran, bukan efikasi. Itulah ceruk Anda — jika Anda meluncurkan produk dengan konsentrasi jujur 8–10% dan klaim yang berdasar, Anda akan memposisikan diri di antara A dan C, tetapi dengan titik harga yang lebih menarik berkat optimalisasi bagian formula lainnya.
Menemukan Ceruk Melalui Diferensiasi Lapisan Fungsional
AI cukup andal dalam mengorganisir bahan berdasarkan peran fungsionalnya (emolien, agen pembentuk gel, pengawet, antioksidan). Setelah Anda melihat distribusi peran di lebih dari 5 kompetitor, akan terlihat jelas di mana pasar sudah jenuh dan di mana ada kekosongan.
- Kejenuhan pasar — jika semua kompetitor menggunakan agen pembentuk gel yang sama (Carbomer) dengan tekstur yang mirip, berdiferensiasi hanya dari tekstur tidak akan efektif — pasar di area itu sudah jenuh.
- Kekosongan pada dukungan barrier — jika tidak ada satu pun kompetitor yang memiliki ceramide atau kolesterol di 10 bahan teratas, dan audiens Anda memiliki kulit sensitif, itulah titik masuknya.
- Pengawetan yang ketinggalan zaman — menemukan Phenoxyethanol + Methylparaben pada kebanyakan kompetitor membuka ceruk untuk formula dengan sistem yang lebih modern seperti Sodium Benzoate + Potassium Sorbate, yang sekaligus bisa menjadi klaim pemasaran "bebas paraben".
Mengoptimalkan Biaya Tanpa Mengorbankan Fungsi
Membaca posisi INCI suatu bahan bersama dengan harga pasar bahan baku yang sudah diketahui memungkinkan Anda memperkirakan biaya kira-kira per batch kompetitor. Jika AI menentukan bahwa kompleks peptida yang mahal berada di posisi ke-12 (artinya konsentrasinya hanya sepersekian persen — "dosis alibi"), Anda bisa memutuskan untuk melewatkannya sama sekali atau menggantinya dengan analog yang lebih murah dengan mekanisme kerja serupa — misalnya, menggunakan Sodium Ascorbyl Phosphate sebagai pengganti asam askorbat murni yang tidak stabil, sehingga klaim antioksidan tetap terjaga sekaligus menyederhanakan stabilisasi formula.
Dari Insight ke Prototipe: Tiga Langkah untuk Formulator
- Kunci satu hipotesis. Berdasarkan laporan AI, rumuskan satu perbedaan konkret: "formula saya akan mengandung 10% Niacinamide, bukan rata-rata pasar 3%" atau "saya akan menghapus alkohol terdenaturasi dari basis dan menggantinya dengan kompleks pelembap."
- Hitung ulang keseimbangan fase. Mengganti atau meningkatkan konsentrasi bahan aktif hampir selalu mengharuskan Anda meninjau ulang emulsifier dan pengental — gunakan laporan sebagai daftar cek kompatibilitas, bukan resep siap pakai.
- Uji pada batch kecil. Batch uji 100–200 g dengan kontrol pH (rentang target untuk kebanyakan serum adalah 5,0–6,0) dan pemeriksaan stabilitas visual pada 48 jam di suhu ruang serta 45°C adalah standar minimum sebelum ditingkatkan skalanya.
Pendekatan ini mengubah analisis AI terhadap kompetitor dari sekadar pengintaian menjadi alat perancangan: Anda tidak mereproduksi formula orang lain, Anda membangun formula Anda sendiri dengan set bahan aktif yang berdasar, biaya yang realistis, dan klaim yang bisa dipertahankan — baik dari sisi bahan maupun secara hukum. Untuk penjelasan lebih lanjut tentang menghitung biaya batch dan memilih sistem pengawetan untuk jenis formula tertentu, lihat artikel kami tentang menghitung biaya formula kosmetik.
Kesimpulan: AI sebagai Alat Intelijen Kompetitif, Bukan Pengganti Ahli Kimia Formulasi
Membedah komposisi INCI kompetitor dengan AI adalah pekerjaan yang berhubungan dengan probabilitas, bukan fakta. Model bahasa menawarkan interpretasi paling mungkin dari urutan bahan, konsentrasi, dan peran fungsional, dengan mengandalkan pola statistik dalam data pelatihannya. Ia tidak pernah membuka kemasannya, tidak pernah melakukan titrasi, dan tidak pernah melihat formula asli merek tersebut. Semua yang dihasilkannya adalah hipotesis yang perlu diperiksa berdasarkan pengetahuan kimia — bukan keputusan final.
Justru karena itulah kombinasi "AI + ahli kimia formulasi" bekerja lebih baik daripada masing-masing alat digunakan sendirian. AI mengambil alih pekerjaan rutin: mengurutkan komponen berdasarkan aturan konsentrasi menurun, mencocokkan nama INCI dengan basis data kelas fungsional, dan menghasilkan draf hipotesis tentang jenis emulsi serta segmen harga kira-kira dari formula tersebut. Ahli kimia mengambil alih apa yang secara mendasar tidak bisa dilakukan model — memeriksa kompatibilitas kimia, menilai stabilitas pada pH dan suhu tertentu, serta menghitung dosis yang realistis dalam batas regulasi.
Apa yang AI Lakukan dengan Baik, dan Apa yang Tidak
| Tugas | Peran AI | Peran Ahli Kimia |
|---|---|---|
| Menerjemahkan fungsi bahan dari INCI | Klasifikasi awal yang cepat | Memeriksa konteks (konsentrasi, bahan-bahan di sekitarnya) |
| Memperkirakan rentang konsentrasi | Kisaran kasar berdasarkan posisi dalam daftar | Penyempurnaan berdasarkan batas regulasi dan pengalaman langsung dengan bahan baku |
| Menghipotesiskan jenis sistem pengemulsi | Memilih pasangan surfaktan yang paling mungkin | Memeriksa kompatibilitas dengan pH dan elektrolit dalam formula |
| Menilai stabilitas formula jadi | Tidak dapat dilakukan secara andal | Perhitungan dan pengujian di laboratorium bersifat wajib |
Pembagian kerja ini bukanlah kompromi — ia mengikuti sifat alat itu sendiri. AI dilatih pada pola teks, bukan kimia fisik dari emulsi. Ia bisa "melihat" Cetearyl Alcohol dan Polysorbate 60 dalam daftar dan mengenali pasangan pengemulsi yang umum, menduga sistem minyak-dalam-air, tetapi ia tidak bisa memverifikasi apakah sistem tersebut tetap stabil setelah Anda menambahkan 2% Niacinamide pada pH 5,0. Hanya spesialis yang memahami diagram fase dan memiliki pengalaman langsung uji stabilitas yang bisa melakukan pemeriksaan tersebut.
Kesimpulan Praktis
Jika dirangkum sebagai protokol kerja, kesimpulannya seperti ini:
- Gunakan AI untuk penerjemahan awal yang cepat terhadap komposisi kompetitor — ini menghemat berjam-jam kerja manual dengan referensi INCI.
- Perlakukan setiap angka konsentrasi dari laporan AI sebagai rentang, bukan nilai pasti, dan periksa ulang terhadap batas regulasi (INCI Dictionary, laporan CIR, serta Peraturan BPOM No. 25 Tahun 2025).
- Verifikasi hipotesis tentang jenis sistem emulsi dan kompatibilitas bahan dengan perhitungan HLB, uji stabilitas, dan pengetahuan kimia fisik — langkah ini tidak bisa didelegasikan kepada model.
- Gunakan insight dari analisis bukan untuk meniru komposisi kompetitor, melainkan untuk membangun formula Anda sendiri yang berbeda dengan set bahan aktif yang berdasar.
Intelijen kompetitif melalui analisis INCI berbasis AI adalah akselerator di awal pengembangan, memangkas analisis pasar awal dari hitungan hari menjadi hitungan jam. Namun, keputusan akhir mengenai konsentrasi bahan aktif, pilihan pengawet, atau sistem pengemulsi tetap berada di tangan ahli kimia formulasi, yang bertanggung jawab atas stabilitas, keamanan, dan kepatuhan regulasi formula jadi. AI memperluas jangkauan seorang spesialis, tetapi tidak menggantikan pengetahuan fundamental tentang kimia kosmetik — dan keseimbangan itulah yang menentukan apakah alat AI menjadi asisten yang bermanfaat atau sumber kesalahan pengembangan yang mahal.
Membedah formula orang lain memang berguna, tetapi membangun formula sendiri jauh lebih berguna. AI Chemist di Walker Formulation Academy Club membantu keduanya: alat ini terhubung dengan basis data INCI yang terverifikasi, sehingga tidak keliru mengenai fungsi bahan dan rentang penggunaannya seperti yang sering terjadi pada chatbot generik. Dan dalam sesi langsung bersama instruktur sungguhan, Anda akan belajar membaca komposisi seperti seorang profesional.
Walker Formulation Academy Club
Menikmati artikel ini? Dapatkan akses ke AI Chemist dan video resep
Asisten AI 24/7 menjawab pertanyaan formulasi, menghitung HLB dan pH, serta membantu Anda memilih bahan. Ditambah komunitas privat sesama ahli kimia dan ulasan produk bulanan.
Tanpa kartu kredit · Batalkan kapan saja
Beri nilai artikel ini
Penilaian Anda membantu pembaca lain menemukan panduan yang bermanfaat
Kursus terkait topik ini
Kimia Kosmetik
Mempelajari kosmetik molekul demi molekul — bahan baku, formula eksklusif, cara membaca daftar INCI. Untuk hobi, bisnis, maupun pengembangan karier profesional.