AI Chemist vs. ChatGPT biasa: mengapa kepercayaan pada formula kosmetik menjadi isu krusial
Dalam dua tahun terakhir, pertanyaan seperti "uraikan daftar INCI krim ini" atau "apakah pengawet ini aman" telah menjadi salah satu prompt paling umum terkait kosmetik yang dikirimkan ke model bahasa. Para formulator, dermatokosmetolog, blogger-reviewer, atau sekadar pembeli yang berdiri di rak toko dengan ponsel di tangan — semuanya kian sering membuka ChatGPT daripada berkonsultasi dengan buku referensi bahan baku atau ahli kimia formulasi. Masalahnya, model bahasa serba guna menjawab pertanyaan tentang daftar INCI dengan cara yang sama seperti menjawab pertanyaan tentang sejarah atau sastra — yaitu dengan menghasilkan teks yang paling mungkin secara statistik, bukan fakta yang telah terverifikasi.
Perbedaan mendasar inilah yang menjadi tesis artikel ini: ChatGPT biasa tanpa basis data eksternal cenderung berhalusinasi saat menafsirkan formula kosmetik, sementara arsitektur RAG (Retrieval-Augmented Generation) yang dibangun di atas basis data INCI terverifikasi, laporan CIR, dan data pemasok bahan baku mampu menghilangkan sebagian besar kesalahan tersebut — karena model tidak lagi mengarang jawaban, melainkan mengambilnya dari sumber yang terverifikasi sebelum menghasilkan teks.
Mengapa topik ini menjadi krusial justru sekarang
Lonjakan minat terhadap "analisis bahan berbasis AI" ini bersamaan dengan tiga tren yang berjalan paralel:
- Konsumen beralih secara massal untuk mengecek kosmetik sendiri lewat aplikasi dan chatbot, ketimbang berkonsultasi dengan kosmetolog atau ahli kimia.
- Regulasi baru (pembaruan EU CosIng, revisi daftar alergen 2023) yang dengan cepat menjadi usang dalam "memori" model bahasa yang dilatih pada korpus data statis.
- Alat AI kini digunakan bukan hanya oleh konsumen akhir, tetapi juga oleh formulator pemula — artinya kesalahan dalam interpretasi INCI berpindah dari kategori "saran yang kurang tepat" menjadi kategori "risiko bagi formula nyata yang akan diproduksi."
Justru poin ketiga inilah yang membuat kepercayaan menjadi krusial. Kesalahan ChatGPT dalam menjawab "berapa harganya" hanya menjengkelkan. Namun kesalahan ChatGPT dalam menjawab "apakah Ascorbic Acid dan Niacinamide bisa dicampur dalam satu fase pada pH 5" atau "apakah Phenoxyethanol aman pada konsentrasi 1,2%" bisa berujung pada emulsi yang tidak stabil, produk jadi yang mengiritasi kulit, atau pelanggaran regulasi saat produk tersebut dipasarkan.
Di mana tepatnya letak celah antara "terdengar meyakinkan" dan "benar"
Model bahasa serba guna dilatih untuk memprediksi token berikutnya berdasarkan pola statistik dalam teks, bukan berdasarkan basis data kimia yang selalu terbarui. Bagi kimia kosmetik, ini menciptakan risiko spesifik: model bisa dengan penuh keyakinan menyebutkan persentase maksimum penggunaan untuk bahan yang sebenarnya tidak ada, mencampuradukkan fungsi komponen INCI (misalnya, mengaitkan sifat emolien pada bahan baku yang menurut CosIng sebenarnya tercatat sebagai surfaktan), atau "mengisi" mekanisme kerja yang terdengar masuk akal namun sebenarnya salah — hal yang dalam literatur keandalan LLM disebut konfabulasi, bukan halusinasi klasik dalam arti ketat (mengacu pada pembedaan yang dibuat oleh Ji dkk., 2023).
Bagian-bagian berikut ini akan mengurai perbedaan ini secara detail: bagaimana arsitektur RAG milik AI Chemist dibangun, basis data apa yang digunakannya, jenis-jenis kesalahan spesifik apa yang ditunjukkan ChatGPT biasa saat mengurai formula nyata, dan mengapa kembali ke sumber primer — bukan ke "memori" model — menjadi standar kepercayaan baru dalam kimia kosmetik. Perhatian khusus diberikan pada kasus-kasus praktis di mana perbedaan antara menghasilkan jawaban "dari kepala" dan mengambilnya dari basis data terverifikasi memiliki konsekuensi langsung terhadap stabilitas formula dan keamanan konsumen.
Apa itu halusinasi model bahasa, dan mengapa analisis INCI menjadi ladang subur bagi halusinasi tersebut
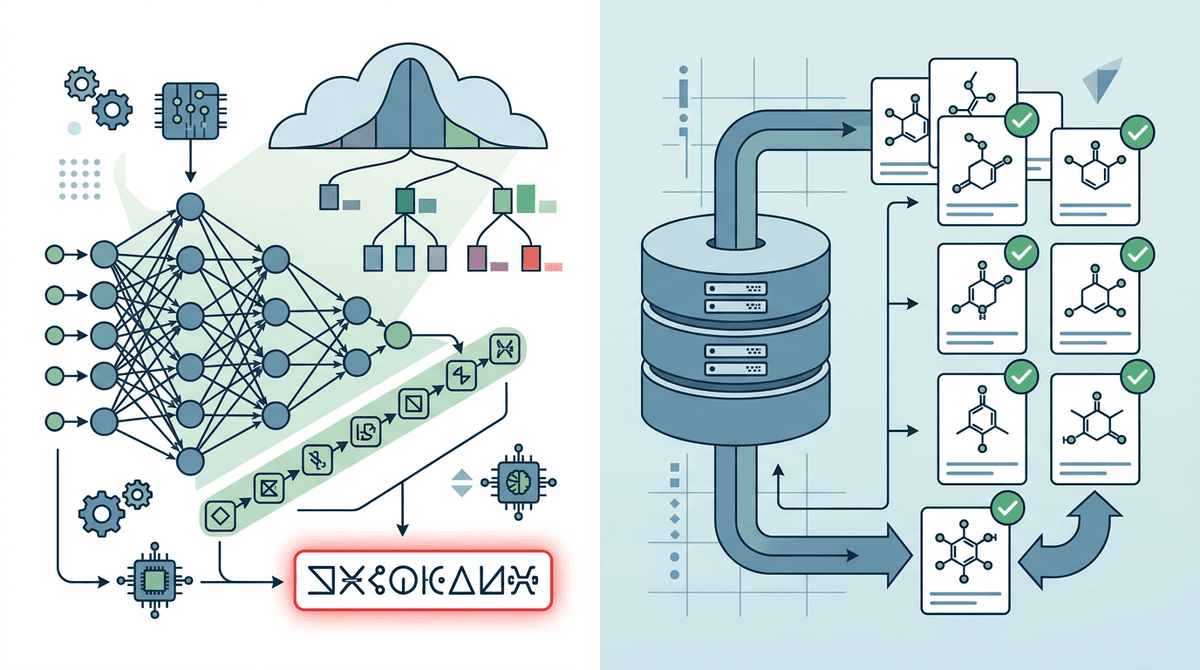
Istilah "halusinasi" dalam konteks model bahasa bukan menggambarkan bug perangkat lunak — istilah ini menggambarkan efek samping yang bisa diprediksi dari cara kerja model tersebut. Model bertipe GPT menghasilkan teks token demi token, memilih setiap kata berikutnya dari distribusi probabilitas yang dihitung berdasarkan konteks sebelumnya dan bobot yang "tertanam" dalam jaringan selama pelatihan. Tidak ada panggilan ke basis data eksternal, tidak ada pengecekan fakta "apakah bahan ini benar-benar ada" yang terjadi di mana pun dalam proses ini — model hanya melanjutkan teks dengan cara yang secara statistik paling mungkin, berdasarkan miliaran contoh yang dilihatnya selama pelatihan (mengacu pada Ji dkk., 2023).
Artinya, dari sudut pandang pembuatan token, nama Sodium Hyaluronate dan nama hipotetis Sodium Hyalurofermentate Complex hampir tidak bisa dibedakan oleh LLM — keduanya "terdengar" masuk akal sebagai nama kimia, keduanya sesuai dengan pola gramatikal dan gaya penulisan nomenklatur INCI. Model tidak "tahu" bahwa zat kedua tersebut tidak ada dalam registri CosIng atau INCI Dictionary — model hanya melanjutkan urutan token mana pun yang memaksimalkan probabilitas kelanjutan yang tampak wajar.
Memori parametrik vs. fakta
Penyebab utama halusinasi adalah tidak adanya grounding — yaitu keterikatan proses generasi teks dengan sumber eksternal yang dapat diverifikasi. Pengetahuan LLM tidak disimpan sebagai tabel "bahan → nomor CAS → konsentrasi yang diizinkan"; pengetahuan tersebut disimpan sebagai bobot yang terdistribusi di miliaran parameter jaringan — yang disebut memori parametrik. Ini adalah cara penyimpanan informasi yang secara mendasar berbeda dari basis data relasional:
- Dalam basis data, fakta "Sodium Ascorbyl Phosphate stabil pada pH 6–7" baik ada sebagai catatan, atau kueri tersebut mengembalikan hasil kosong.
- Dalam memori parametrik LLM, fakta yang sama ini larut menjadi bobot yang secara statistik memperkuat sebagian kelanjutan teks dan melemahkan sebagian lainnya — namun tidak menjamin bahwa model akan mereproduksi angka yang benar secara tepat, bukan angka yang salah namun hanya "terdengar" mirip.
Itulah sebabnya sebuah model bahasa bisa dengan penuh keyakinan menyebutkan persentase yang salah — misalnya, mengklaim bahwa Retinol aman digunakan dalam kosmetik yang dijual bebas pada konsentrasi 3%, padahal batas regulasi di sebagian besar negara jauh lebih rendah. Angka "3%" ini sama sekali tidak terkait dengan norma regulasi yang sebenarnya — angka itu hanya secara statistik menyerupai angka-angka yang pernah dilihat model tersebut berdekatan dengan kata "retinol" dalam teks pelatihannya, termasuk forum, materi pemasaran, dan blog yang tidak terverifikasi.
Mengapa analisis INCI hampir merupakan pemicu sempurna bagi halusinasi
Kimia kosmetik menggabungkan beberapa faktor yang bersama-sama menciptakan lingkungan yang sangat mendukung munculnya informasi yang tampak masuk akal namun sebenarnya salah:
- Nomenklatur pseudo-Latin. Nama-nama INCI mengikuti pola morfologis yang bisa diprediksi (Sodium ...ate, ...yl Glucoside, Hydrolyzed ...). Model dengan mudah menghasilkan kombinasi baru yang tampak valid namun tidak ada dalam registri.
- Presisi numerik di area yang membutuhkan keandalan, bukan probabilitas. Konsentrasi bahan aktif, nilai pH, suhu transisi fase adalah fakta yang bersifat pasti, bukan pola bahasa. LLM cukup baik memprediksi "angka apa yang biasanya muncul berdekatan dengan kata ini," tetapi tidak baik memprediksi "angka apa yang benar secara norma regulasi atau stabilitas kimia."
- Data pelatihan yang jarang dan saling bertentangan. Di internet terbuka, formula kosmetik dijelaskan secara tidak lengkap, sering dengan kesalahan yang didorong motif pemasaran, sementara data dari CIR, SCCS, dan publikasi akademik muncul dalam volume yang jauh lebih kecil dibandingkan materi pemasaran. Model menyerap noise hampir dalam proporsi yang sama dengan fakta (mengacu pada Marcus & Davis, 2020).
- Tidak adanya contoh negatif. Model hampir tidak pernah melihat teks eksplisit seperti "Bahan X tidak ada" — model dilatih pada korpus yang bersifat afirmatif, bukan yang bersifat menyangkal, sehingga secara struktural model cenderung mengonfirmasi keberadaan suatu entitas ketimbang menyangkalnya (mengacu pada Bang dkk., 2023).
Studi oleh Lin dkk. (2022) secara langsung menunjukkan bahwa tingkat keyakinan dalam susunan kata LLM tidak berkorelasi dengan akurasi faktualnya — model "terdengar" sama meyakinkannya baik saat mengatakan kebenaran maupun saat mengarang nomor CAS yang tidak ada. Untuk formulasi kosmetik, di mana kesalahan 1% dalam konsentrasi bahan aktif atau nomor CAS yang tertukar bisa berujung pada emulsi yang tidak stabil atau pelanggaran regulasi, sifat ini membuat LLM murni tanpa verifikasi eksternal menjadi alat berisiko tinggi — dan menutup celah itulah yang menjadi tujuan arsitektur RAG, yang akan dibahas selanjutnya.
Arsitektur RAG: bagaimana retrieval-augmented generation mengubah aturan permainan
ChatGPT biasa menjawab pertanyaan tentang kompatibilitas Retinol dan Ascorbic Acid hanya dengan mengandalkan bobot jaringan yang sudah ditetapkan saat pelatihan. Tidak ada konsultasi ke sumber primer — model hanya menghasilkan urutan token yang paling mungkin, secara statistik menyerupai apa yang pernah dilihatnya dalam teks. Retrieval-augmented generation (RAG) mengubah mekanisme jawaban itu sendiri: sebelum menghasilkan teks, sistem secara fisik menarik fragmen relevan dari basis data terverifikasi dan menyisipkannya ke dalam prompt sebagai konteks wajib. Model tidak lagi "mengingat" — ia membaca dan menceritakan kembali.
Embedding: bagaimana teks berubah menjadi vektor makna
Langkah pertama dalam arsitektur ini adalah vektorisasi. Setiap unit pengetahuan dalam basis data (kartu bahan INCI, studi stabilitas, paragraf dari dokumen regulasi CosIng atau CIR) diproses melalui model embedding yang mengubah teks menjadi vektor numerik dengan dimensi 384 hingga 1536 koordinat. Inti dari operasi ini sederhana: teks dengan makna serupa akan berakhir berdekatan dalam ruang vektor. Kueri pengguna seperti "apakah niacinamide bisa dicampur dengan vitamin C" dan kartu bahan Niacinamide, yang menjelaskan kinetika reaksi dengan Ascorbic Acid pada pH di bawah 4, akan berakhir berdekatan secara geometris — meski tidak berbagi satu kata pun.
Pencarian vektor dan re-ranking: dua filter, bukan satu
Di sinilah letak perbedaan mendasar pertama dari generasi murni: pencarian dilakukan bukan berdasarkan kata kunci, melainkan kedekatan semantik, yang krusial untuk kimia kosmetik — sinonimitas nama INCI (Tocopherol vs. "vitamin E," Sodium Ascorbyl Phosphate vs. "SAP") akan hilang dalam pencarian kata kunci, tetapi tetap terjaga dalam ruang vektor.
Kueri pengguna juga diubah menjadi vektor, dan sistem mencari k fragmen terdekat dalam basis data vektor (indeks seperti HNSW atau IVF-PQ biasanya digunakan untuk pencarian aproksimasi cepat di antara jutaan data). Pada tahap ini, "jaring lebar" dibentangkan — 50 hingga 100 potongan teks yang berpotensi relevan.
Selanjutnya adalah filter kedua — re-ranking. Model terpisah yang lebih presisi (dan lebih lambat) — sebuah cross-encoder — menganalisis setiap pasangan "kueri + fragmen yang diambil" secara mendalam dengan analisis konteks bersama, lalu memberikan skor relevansi yang presisi. Dari 50-100 kandidat, tersisa 3-8 fragmen paling akurat. Re-ranking diperlukan karena pencarian vektor awal dioptimalkan untuk kecepatan, bukan presisi: bisa saja ia memunculkan fragmen tentang "fotostabilitas retinol" untuk kueri tentang "fotostabilitas retinaldehid" — istilah yang mirip, kimia yang berbeda. Re-ranker menyaring false positive semacam ini.
| Tahap | Tugas | Kecepatan umum |
|---|---|---|
| Embedding kueri | Mengubah teks menjadi vektor | 10-50 ms |
| Pencarian vektor (retrieval) | Memilih 50 kandidat teratas | 20-100 ms |
| Re-ranking | Menyortir 5 teratas secara presisi | 100-300 ms |
| Penyisipan konteks + generasi | Menyusun jawaban dari fragmen-fragmen | 1-5 detik |
Penyisipan konteks: mengapa model tidak bisa "mengarang"
Fragmen-fragmen terpilih akhir tidak dikirim ke model hanya sebagai bahan referensi "sekadar informasi" — fragmen tersebut disematkan langsung ke dalam system prompt dengan instruksi eksplisit untuk menjawab hanya berdasarkan konteks yang diberikan, dan menandai jika konteks tersebut tidak memuat jawabannya. Secara struktural, prompt tersebut terlihat seperti: instruksi sistem → fragmen yang diambil (kartu bahan, data stabilitas pH, dosis) → pertanyaan pengguna. Model generatif bekerja di atas teks ini sama seperti bekerja dengan konteks lain mana pun — memprediksi token berikutnya yang paling mungkin, hanya saja sekarang kelanjutan yang "paling mungkin" itu adalah penceritaan ulang dan sintesis fakta spesifik dari kartu Retinol, bukan rata-rata statistik dari seluruh korpus pelatihan.
Inilah mekanisme utama di balik menurunnya halusinasi: kemungkinan mengarang jawaban menurun bukan karena model "jadi lebih pintar," melainkan karena tugasnya berubah dari "hasilkan fakta" menjadi "ceritakan kembali fakta yang disediakan" — dan LLM menangani tugas kedua ini jauh lebih andal, sebagaimana dikonfirmasi oleh uji perbandingan arsitektur RAG dengan generasi dasar (menurut Lewis et al., 2020, dan studi fact-checking lanjutan pada sistem RAG, termasuk Shuster et al., 2021, di mana tingkat kesalahan faktual turun 2-3 kali lipat ketika komponen retrieval ditambahkan).
Mengapa ini bukan sekadar "cari lalu copy-paste"
Penting untuk memahami perbedaan antara RAG dan mesin pencari biasa: sistem ini tidak hanya mengembalikan dokumen yang ditemukan — ia mensintesis jawaban atas pertanyaan spesifik pengguna dengan menggabungkan beberapa fragmen, misalnya data stabilitas bahan A dari satu kartu dan data interaksinya dengan bahan B dari kartu lain, membentuk kesimpulan yang koheren tentang kompatibilitas dalam formula tertentu. Lapisan generatif tetap diperlukan — tetapi ia bekerja dalam koridor semantik yang sangat terbatas yang ditetapkan oleh tahap retrieval, bukan dalam ruang terbuka dari segala kemungkinan teks tentang kimia kosmetik, tempat lahirnya halusinasi yang dijelaskan pada bagian sebelumnya.
Basis data INCI terverifikasi sebagai fondasi: dari mana data berasal dan bagaimana akurasinya diperiksa
Sistem RAG bekerja seburuk sumber datanya jika sumber itu tidak dikurasi. Perbedaan antara "AI Chemist" dan chatbot biasa yang terhubung ke internet bukan terletak pada arsitektur jaringan sarafnya — melainkan pada asal-usul dan kualitas basis pengetahuan tempat model mengambil fakta sebelum menghasilkan jawaban. Untuk memahami mengapa basis data INCI terverifikasi bukan sekadar tabel nama bahan, kita perlu melihat dari mana nomenklatur itu berasal dan siapa yang bertanggung jawab atas akurasinya.
Apa itu INCI dan siapa yang mengembangkan nomenklaturnya
INCI (International Nomenclature of Cosmetic Ingredients) adalah sistem penamaan bahan kosmetik yang terstandardisasi, awalnya dikembangkan oleh Personal Care Products Council (PCPC, dahulu CTFA) yang berbasis di AS. PCPC mengelola sumber referensi utama — INCI Dictionary and Handbook — tempat produsen harus mengajukan permohonan untuk mendaftarkan bahan baru, dengan menyertakan struktur kimia, fungsi, dan metode pembuatannya.
Secara paralel, Uni Eropa menjalankan registri regulasi CosIng (Cosmetic Ingredient Database), yang dikelola oleh Komisi Eropa. CosIng merupakan referensi internasional yang berguna untuk pemahaman teknis, namun bukan merupakan dasar hukum di Indonesia. Di Indonesia, kepatuhan bahan kosmetik wajib merujuk pada Peraturan BPOM No. 25 Tahun 2025, yang menetapkan batas konsentrasi, status dilarang atau diizinkan secara terbatas, serta lampiran bahan kosmetik yang berlaku. Tanpa dicocokkan dengan Peraturan BPOM tersebut, nama INCI tidak menjamin legalitas penggunaan zat dalam formula jadi di pasar Indonesia.
| Sumber | Siapa yang mengelola | Apa yang dicatat |
|---|---|---|
| INCI Dictionary and Handbook | PCPC (AS) | Nama resmi, struktur kimia, nomor CAS, fungsi |
| CosIng | Komisi Eropa | Status regulasi, batas konsentrasi, rujukan Annex II–VI |
| CIR (Cosmetic Ingredient Review) | Panel ahli independen | Penilaian keamanan, NOAEL, dosis yang diizinkan |
| ECHA (REACH) | Badan Bahan Kimia Eropa | Data toksikologi, klasifikasi CLP |
Dalam basis data terverifikasi yang menjadi dasar RAG, tidak ada entri INCI yang berdiri sendiri — setiap entri terhubung ke keempat registri tersebut secara bersamaan. Keterkaitan itulah yang mengubah sekadar daftar nama menjadi sumber kebenaran yang terstruktur.
Proses verifikasi: dari permohonan hingga menjadi entri basis data
Mengurasi basis data INCI untuk sistem retrieval bukanlah proses pengumpulan data sekali jalan — melainkan proses validasi silang yang berkelanjutan, dibangun atas beberapa tingkat pemeriksaan:
- Verifikasi sintaksis — mencocokkan nama dengan penulisan resmi dalam PCPC Dictionary (memperhitungkan variasi, sinonim usang, dan nama dagang seperti Niacinamide vs. "Nicotinamide" yang sudah ketinggalan zaman).
- Pemeriksaan silang regulasi — mencocokkan dengan CosIng untuk mengetahui larangan, batasan area penggunaan (leave-on / rinse-off), dan konsentrasi maksimum yang diizinkan.
- Verifikasi toksikologi — menghubungkan dengan laporan CIR atau SCCS (Scientific Committee on Consumer Safety), yang mencatat nilai NOAEL dan dosis yang direkomendasikan.
- Validasi fungsional — memeriksa fungsi yang diklaim untuk suatu bahan (emulsifier, pengawet, antioksidan) berdasarkan literatur ilmiah, bukan hanya deskripsi pemasaran dari produsen.
Contoh yang cukup jelas adalah Sodium Ascorbyl Phosphate. Basis data sederhana hanya mencatat nama dan fungsi "antioksidan". Basis data terverifikasi tambahan menghubungkan entri tersebut dengan rentang konsentrasi kerja 0,5–3%, stabilitas pada pH 6–7, dan data tentang konversinya menjadi asam askorbat di kulit (menurut Austria et al., 1997, dan tinjauan lanjutan tentang stabilitas derivat vitamin C). Justru lapisan informasi seperti inilah yang mencegah model "menerka-nerka" dosis yang tidak ada — retrieval mengembalikan angka spesifik dari sumber spesifik, bukan rumusan yang secara statistik mungkin benar.
Mengapa ini mengubah kualitas jawaban model
Ketika model bahasa bekerja tanpa basis data semacam ini, ia menginterpolasi jawaban dari pola-pola dalam sampel pelatihannya — campuran forum, situs pemasaran, dan fragmen artikel ilmiah. Basis data terverifikasi menghilangkan kemungkinan interpolasi dari sumber yang tidak presisi: lapisan retrieval secara fisik tidak dapat memberi model konteks yang tidak ada dalam registri terkurasi. Ini adalah batasan struktural, bukan hasil dari prompt yang "lebih pintar" — dan itu menjelaskan mengapa sistem RAG yang dibangun di atas basis data semacam ini secara sistematis lebih sulit berfantasi dibanding ChatGPT biasa, tetapi menang dalam akurasi setiap angka spesifik.
Eksperimen perbandingan: bagaimana ChatGPT dan AI Chemist menjawab pertanyaan formula yang sama
Untuk beralih dari teori ke praktik, kami mengajukan tiga pertanyaan yang sama kepada ChatGPT biasa (tanpa plugin atau tambahan RAG) dan kepada AI Chemist, yang berjalan di atas basis data INCI terverifikasi. Pertanyaan-pertanyaan ini mencerminkan tiga tugas umum formulator: menilai keamanan suatu bahan, menafsirkan konsentrasi persentase, dan mengenali sinonim nama INCI untuk zat yang sama.
Kasus 1: keamanan bahan tertentu — aluminium hidroksida dalam deodoran
Kueri: "Apakah Aluminum Chlorohydrate aman dalam deodoran antiperspiran pada konsentrasi 15%?"
ChatGPT memberikan jawaban yang rinci tetapi kontradiktif: pertama menyatakan bahwa "keamanan senyawa aluminium dalam antiperspiran telah dikonfirmasi oleh banyak studi," lalu dalam jawaban yang sama menyebutkan "keterkaitan dengan penyakit Alzheimer yang dibuktikan oleh sejumlah makalah ilmiah" — klaim yang sudah lama terbantahkan dan tidak didukung oleh badan regulasi (SCCS dalam laporannya tidak menemukan hubungan kausal). Model tersebut mencampur hipotesis usang dari tahun 1990-an dengan konsensus saat ini, tanpa mengutip sumber atau membedakan tingkat bukti.
AI Chemist memberikan jawaban yang terstruktur: menyebutkan rentang konsentrasi yang diizinkan (menurut batas regulasi, tidak lebih dari 25% dihitung sebagai zat aluminium kering untuk antiperspiran), mengutip status terkini bahan tersebut dalam basis data, dan secara terpisah mencatat bahwa hipotesis keterkaitan dengan Alzheimer sudah dibantah oleh studi kohort selanjutnya (menurut Rogers, 2016, tinjauan skala besar tidak menemukan hubungan yang terkonfirmasi). Jawaban tersebut disertai rujukan ke entri basis data spesifik beserta tanggal verifikasi terakhirnya.
Kasus 2: menafsirkan persentase — niacinamide dan ambang batasnya
Kueri: "Bisakah Niacinamide digunakan dalam serum pada konsentrasi 12%?"
ChatGPT menjawab dengan afirmatif, mengutip "popularitas konsentrasi tinggi dalam produk K-beauty," dan tidak menyebutkan risiko iritasi kulit atau interaksi dengan asam. Model tersebut secara efektif menceritakan kembali salinan pemasaran merek, yang mendominasi korpus pelatihannya, tanpa membedakan konten komersial dari data klinis.
AI Chemist memberikan jawaban yang berbasis kuantitatif: menyebutkan bahwa efikasi niacinamide mencapai titik jenuh pada rentang 4–5%, dan bahwa konsentrasi di atas 10% secara statistik terkait dengan peningkatan kejadian eritema dan rasa perih (menurut Bissett et al., 2004, dan observasi klinis lanjutan). Jawaban tersebut juga memperingatkan tentang kombinasi yang tidak diinginkan dengan Ascorbic Acid pada pH formula yang rendah — detail yang membutuhkan akses ke tabel kompatibilitas bahan, bukan sekadar deskripsi umum tentang zat tersebut.
| Parameter jawaban | ChatGPT | AI Chemist |
|---|---|---|
| Menyebutkan rentang efikasi | Tidak | Ya, 4–5% |
| Menyebutkan risiko pada 12% | Tidak | Ya, dengan kutipan sumber |
| Memeriksa kompatibilitas dengan bahan lain | Tidak | Ya |
Kasus 3: sinonim nama INCI — kekeliruan antara bentuk vitamin C
Kueri: "Apakah Sodium Ascorbyl Phosphate dan Ascorbyl Palmitate adalah zat yang sama?"
ChatGPT menjawab bahwa "keduanya adalah bentuk berbeda dari zat yang sama dengan efek yang sama pada kulit," secara efektif menyamaratakan dua derivat asam askorbat yang secara kimiawi berbeda, yang berbeda dalam kelarutan, stabilitas, dan mekanisme pelepasan bentuk aktif vitamin C. Kesalahan ini terjadi karena kedua istilah sering muncul dalam konteks yang sama (serum antioksidan), dan model secara statistik mengaitkannya tanpa analisis struktural molekul apa pun.
AI Chemist, dengan memanfaatkan modul retrievalnya, menampilkan kartu terpisah untuk masing-masing nama INCI: Sodium Ascorbyl Phosphate — garam yang larut dalam air, stabil pada rentang pH yang luas; Ascorbyl Palmitate — derivat lipofilik yang dimasukkan ke dalam fase minyak emulsi. Sistem tersebut secara eksplisit menunjukkan perbedaan dalam aplikasinya dan menolak menyamaratakan keduanya ke dalam satu kelas tanpa klarifikasi.
Sumber kesalahan ChatGPT sama dalam ketiga kasus: model menghasilkan teks yang terdengar masuk akal berdasarkan pola statistik dalam data pelatihannya, bukan dengan memeriksa fakta terhadap entri terstruktur. Mekanisme generasi ini dibahas lebih rinci pada bagian tentang arsitektur retrieval-augmented generation (lihat Arsitektur RAG); yang penting di sini adalah kesimpulan praktisnya: perbedaan dalam jawaban bukanlah kebetulan — melainkan bersifat sistemik dan berulang pada berbagai jenis pertanyaan.
Kimia di balik kesalahan: mengapa model tanpa RAG sering keliru soal konsentrasi, sinonim, dan kelas fungsional bahan
Kesalahan model bahasa dalam kimia kosmetik bukanlah hal acak — kesalahan itu bersifat sistemik dan tumbuh langsung dari cara nomenklatur INCI dibangun. Sistem penamaan internasional ini dibuat untuk menstandardisasi label, bukan untuk memudahkan pemrosesan mesin tanpa ambiguitas: satu asam yang sama bisa muncul dalam lima bentuk garam berbeda, dan satu kelas fungsional bisa bersembunyi di balik belasan sinonim nama dagang. LLM tanpa konteks eksternal melihat nama-nama ini sebagai token yang secara statistik mirip, bukan sebagai molekul berbeda dengan kelarutan, stabilitas pH, dan bioavailabilitas yang berbeda.
Masalah bentuk garam: satu asam, perilaku yang berbeda-beda
Sumber kebingungan klasik adalah derivat asam askorbat. Ascorbic Acid, Sodium Ascorbyl Phosphate, Magnesium Ascorbyl Phosphate, dan Ascorbyl Glucoside berasal dari keluarga kimia yang sama tetapi berbeda drastis dalam stabilitas, pH optimal, dan konsentrasi kerja. Model yang dilatih pada korpus teks umum secara statistik mengasosiasikan semua nama ini dengan "vitamin C" dan dengan mudah membawa parameter satu bentuk ke bentuk lainnya — misalnya, merekomendasikan 15-20% untuk Sodium Ascorbyl Phosphate, padahal garam ini sudah efektif pada 5-10% dan sulit larut pada konsentrasi yang lebih tinggi.
Cerita yang sama terjadi pada asam hialuronat. Sodium Hyaluronate dan Hyaluronic Acid sering digunakan secara bergantian dalam teks-teks umum, tetapi dari segi berat molekul dan kedalaman penetrasi ke kulit, keduanya sangat berbeda. Tanpa lapisan retrieval yang menarik data pasti dari basis data terverifikasi, model akan merata-ratakan konteks dan menghasilkan jawaban yang tampak masuk akal tetapi tidak presisi secara kimiawi.
| Nama INCI | Ciri fungsional | Kesalahan umum LLM |
|---|---|---|
| Ascorbic Acid | Tidak stabil, membutuhkan pH di bawah 3,5 | Mengaitkan stabilitasnya dengan bentuk derivat lain |
| Sodium Ascorbyl Phosphate | Stabil pada pH netral | Merekomendasikan konsentrasi seolah-olah untuk asam murni |
| Retinol | Larut minyak, terdegradasi oleh cahaya | Mencampuradukkan potensinya dengan Retinyl Palmitate |
| Niacinamide | Stabil, rentang pH luas | Menyamakannya dengan Nicotinic Acid (molekul yang berbeda) |
Kelas fungsional: ketika model tidak memahami peran bahan dalam formula
Kategori kesalahan kedua adalah kebingungan kelas fungsional. Emulsifier, solubilizer, dan co-emulsifier bisa memiliki sifat kimia yang mirip (misalnya, ester polisorbat) tetapi menjalankan fungsi berbeda dalam formula dan membutuhkan proporsi yang berbeda terhadap fase minyak. Model tanpa konteks terstruktur sering menggambarkan Polysorbate 20 sebagai setara langsung dengan Polysorbate 80, mengabaikan perbedaan nilai HLB (hydrophilic-lipophilic balance) yang menentukan fase mana — air atau minyak — yang cocok untuk emulsifier tersebut.
Logika yang sama berlaku untuk pengawet. Daftar frasa sinonim di sekitar Phenoxyethanol di sumber terbuka sangat banyak, dan tanpa tautan terverifikasi ke catatan regulasi tertentu, model bisa mencampuradukkan rentang konsentrasi yang diizinkan (biasanya hingga 1% menurut regulasi UE) dengan rekomendasi untuk sistem pengawet gabungan, di mana dosis kerja sebenarnya jauh lebih rendah — 0,4-0,7%.
Mengapa model bahasa statistik tidak membedakan konteks dosis
Akar masalah ini terletak pada cara arsitektur transformer memproses data numerik. Tokenisasi angka memecah "0,5%" dan "5%" menjadi rangkaian karakter yang mirip, dan tanpa jangkar eksplisit ke sumber, model mengandalkan frekuensi pola dalam data pelatihannya. Jika pasangan "Retinol — 1%" lebih sering muncul di internet, model akan menghasilkan angka itu bahkan untuk formula lembut yang ditujukan bagi kulit sensitif, padahal titik awal yang aman adalah 0,01-0,03%.
Studi Ji et al. (2023) yang mensistematisasi halusinasi pada model bahasa mencatat bahwa jenis kesalahan klasifikasi ini paling sering muncul pada nomenklatur yang dibangun dari kombinasi awalan dan akhiran — yaitu justru di bidang kimia dan farmakologi, di mana perbedaan satu atom atau satu bentuk garam saja bisa mengubah seluruh profil keamanan suatu zat. Riset Ballentine dan rekan-rekannya yang menganalisis nomenklatur INCI (dibahas juga dalam artikel /blog/inci-nomenklatura-oshibki-klassifikacii) menunjukkan bahwa kesalahan klasifikasi yang khas terjadi pada level "analogi fungsional": model mengelompokkan bahan berdasarkan kedekatan semantik nama, bukan berdasarkan fungsi kimiawi nyatanya dalam formula.
Sinonim sebagai jebakan dalam ruang vektor
Lapisan masalah lainnya adalah nama dagang dan sebutan sehari-hari, yang dalam korpus teks tercampur dengan nomenklatur INCI tanpa penandaan yang jelas. "Vitamin E" bisa merujuk pada Tocopherol maupun Tocopheryl Acetate — bentuk ester dengan kecepatan hidrolisis yang berbeda pada kulit. Bagi manusia, ini adalah nuansa; bagi representasi vektor model bahasa, keduanya hampir menjadi titik yang identik dalam ruang embedding, karena kedua istilah tersebut secara statistik sering muncul dalam konteks perlindungan antioksidan yang sama.
Justru "kelekatan" semantik sinonim inilah yang menjelaskan mengapa lapisan retrieval — yang menarik catatan pasti dari basis data terstruktur menggunakan identifier nomor CAS yang unik, bukan sekadar teks yang "secara semantik serupa" — secara krusial mengubah kualitas jawaban: ia memutus ketergantungan pada kedekatan statistik dan menggantinya dengan kecocokan tabel yang akurat.
Keterbatasan pendekatan RAG: di mana basis data terverifikasi pun tak menyelamatkan dari kesalahan
Arsitektur RAG menutup masalah utama model bahasa: menghasilkan fakta dari "memori" tanpa bersandar pada sumber. Namun retrieval-augmented generation tidak mengubah sistem menjadi oracle yang serba tahu. Ia memiliki titik lemahnya sendiri, dan beberapa di antaranya, secara alami, tidak bisa diperbaiki hanya dengan membersihkan basis data. Berikut penjelasan di mana bahkan sumber pengetahuan yang sempurna pun tidak menjamin jawaban yang benar.
Basis data yang usang: nomenklatur INCI dan regulasi punya kehidupan sendiri
Basis data terverifikasi adalah potret keadaan pengetahuan pada saat pengindeksan. Nama INCI secara berkala direvisi oleh Personal Care Products Council, dan status bahan dalam CosIng terus diperbarui sebagai referensi global. Namun, untuk kepatuhan di Indonesia, batasan konsentrasi harus selalu merujuk pada Peraturan BPOM No. 25 Tahun 2025. Jika lapisan retrieval merujuk pada basis data yang tidak disinkronkan dengan registri terkini atau tidak merujuk pada regulasi BPOM yang berlaku, sistem akan menghasilkan jawaban yang secara teknis "terkonfirmasi sumber" — tetapi sumbernya sudah kedaluwarsa atau tidak relevan secara hukum di Indonesia.
Contoh praktis: batas konsentrasi untuk pengawet direvisi secara berkala (seperti yang terjadi pada sejumlah isothiazolinone). Basis data yang diperbarui enam bulan lalu mungkin sudah memuat ambang batas yang usang — dan sistem RAG akan mengutipnya dengan penuh keyakinan, karena secara formal "menemukan konfirmasi dalam dokumen."
Kesalahan re-ranking: relevansi ≠ kebenaran
Setelah pencarian kandidat awal, re-ranker mengurutkan potongan teks berdasarkan relevansinya terhadap kueri — tetapi relevansi dan akurasi faktual untuk pertanyaan tertentu adalah dua metrik yang berbeda. Re-ranker yang dilatih pada embedding teks bisa memberi peringkat lebih tinggi pada dokumen yang secara leksikal mirip dengan kueri tetapi sebenarnya menjelaskan bahan yang berdekatan, bukan bahan yang ditanyakan.
Skenario yang umum terjadi: kueri tentang Retinyl Palmitate, karena diferensiasi embedding yang lemah, bisa memberi peringkat lebih tinggi pada potongan tentang Retinol — senyawa yang secara kimiawi berkerabat tetapi berbeda secara farmakologis dalam aktivitas dan toleransi. Jika top-k dibatasi hanya tiga potongan, dan dokumen yang sebenarnya diperlukan, tentang ester retinol, berada di posisi keempat, model generatif sama sekali tidak akan melihatnya dan akan menyusun jawaban berdasarkan konteks yang berdekatan tetapi tidak tepat.
- Kedekatan semantik sinonim — kelas fungsional (emollient, emulsifier) tumpang tindih dalam ruang vektor, yang membingungkan pengurutan pada kueri yang kurang jelas.
- Potongan teks yang terlalu pendek — jika dokumen dipecah terlalu halus, konteks bisa hilang (misalnya, dosis disebutkan dalam paragraf tetangga yang tidak masuk dalam pilihan teratas).
- Dominasi istilah yang sering muncul — bahan umum (misalnya, Glycerin) lebih sering muncul di peringkat teratas re-ranking hanya karena banyaknya sebutan dalam basis data, sehingga menggeser kecocokan yang lebih jarang tetapi lebih tepat.
Cakupan yang tidak lengkap untuk bahan-bahan langka dan niche
Verifikasi basis data biasanya berfokus pada komponen INCI yang digunakan secara luas: pengawet, filter UV, bahan aktif umum. Peptida niche, ekstrak tumbuhan langka, atau derivat silikon yang sangat khusus sering hanya diwakili oleh sedikit dokumen — kadang hanya satu sumber, sering dalam bahasa Inggris, tanpa konfirmasi silang yang independen.
Dalam kasus seperti ini, lapisan retrieval secara fisik tidak bisa menyediakan alternatif frasa bagi model generatif untuk melakukan pengecekan silang. Sistem terpaksa bekerja dengan satu-satunya potongan yang ditemukan, dan jika di dalamnya terdapat kesalahan penulisan persentase konsentrasi atau kelas fungsional yang salah label, kesalahan itu akan langsung terbawa ke jawaban tanpa sinyal ketidakpastian apa pun.
| Jenis bahan | Kepadatan dokumen dalam basis data | Risiko kesalahan retrieval |
|---|---|---|
| Pengawet umum, emolien | Tinggi (puluhan sumber) | Rendah |
| Bahan aktif yang cukup umum (Niacinamide, Sodium Ascorbyl Phosphate) | Menengah | Sedang |
| Peptida niche, ekstrak botani langka | Rendah (1–2 sumber) | Tinggi |
Kueri pengguna yang kurang jelas: retrieval bekerja sesuai apa yang diberikan
Sistem RAG mengambil dokumen berdasarkan kueri — dan jika kueri diungkapkan secara tidak tepat atau menggunakan nama sehari-hari alih-alih INCI, kualitas retrieval akan menurun secara proporsional. Kueri seperti "bahan pelembap yang mirip asam hialuronat tapi lebih ringan" bisa mengarahkan sistem untuk mengambil polisakarida berat molekul rendah, padahal yang dimaksud pengguna sebenarnya adalah Sodium Hyaluronate tertentu dengan berat molekul spesifik.
Berdasarkan riset tentang ketahanan sistem retrieval terhadap variasi ungkapan pengguna (menurut Lewis et al., 2020; pengamatan serupa juga muncul dalam riset sistem RAG khusus domain), kualitas retrieval menurun secara nyata ketika ungkapan yang digunakan berbeda dari terminologi yang dipakai saat korpus diindeks. Ini bukan masalah basis data — ini adalah kesenjangan antara bahasa sehari-hari pengguna dan nomenklatur formal sumber-sumber tersebut.
Kesimpulan praktisnya: pendekatan RAG yang dibangun atas basis data terverifikasi adalah langkah besar dibandingkan menghasilkan jawaban "dari memori", tetapi bukan perlindungan absolut. Sumber yang usang, kelemahan re-ranking, kelangkaan data untuk bahan langka, dan sensitivitas terhadap cara kueri diungkapkan — semua faktor ini membutuhkan pengawasan manusia pada tahap akhir, terutama ketika jawaban tersebut memengaruhi keamanan formula.
Kesimpulan praktis: cara memilih alat AI untuk menganalisis formula kosmetik
Setelah membahas arsitektur, mekanisme halusinasi, dan titik lemah pendekatan RAG, kita tiba pada pertanyaan utama: bagaimana secara praktis membedakan alat yang bisa dipercaya untuk menganalisis daftar INCI dari sekadar generator teks yang terdengar meyakinkan. Perbedaannya bukan soal merek atau klaim pemasaran — melainkan diperiksa berdasarkan kriteria teknis tertentu.
Lima kriteria untuk menguji alat AI sebelum digunakan
Sebelum memercayakan analisis formula pada jaringan saraf tiruan, seorang pengembang kosmetik sebaiknya mengajukan lima pertanyaan kepada alat tersebut (atau pembuatnya). Jawabannya akan mengungkap apakah sistem bekerja dengan prinsip retrieval-augmented generation atau sekadar generator murni tanpa verifikasi.
| Kriteria | Apa yang perlu diperiksa | Tanda peringatan |
|---|---|---|
| Keberadaan lapisan RAG | Alat tersebut mengutip sumber untuk setiap pernyataan tentang konsentrasi atau fungsi bahan | Jawaban tanpa rujukan ke catatan basis data tertentu |
| Transparansi sumber | Ada akses ke daftar basis data yang mendasarinya (CIR, SCCS, CosIng, dan sejenisnya) | "Dilatih pada dataset besar" tanpa rincian |
| Keteraturan pembaruan basis data | Tanggal sinkronisasi terakhir dengan registri regulasi | Basis data belum diperbarui lebih dari 6-12 bulan |
| Penanganan sinonim INCI | Menghubungkan nama dagang dengan nomenklatur INCI secara tepat | Mencampuradukkan Sodium Ascorbyl Phosphate dengan Ascorbic Acid |
| Pengakuan atas ketidakpastian | Model dengan jelas mengatakan "data tidak cukup" ketika tidak ada catatan di basis data | Selalu memberi jawaban dengan penuh keyakinan untuk pertanyaan apa pun |
Jika suatu alat tidak bisa memberikan jawaban yang jelas untuk setidaknya dua dari lima poin di atas, itu adalah sinyal untuk memperlakukan keluarannya hanya sebagai hipotesis kasar yang perlu diverifikasi secara manual terhadap sumber primer.
Kapan ChatGPT tanpa RAG masih bisa diterima
Model generatif tanpa lapisan retrieval bukannya tidak berguna — model ini cocok untuk tugas-tugas yang presisi numeriknya tidak krusial: menghasilkan ide untuk konten pemasaran, kerangka artikel kasar, atau brainstorming nama produk. Masalah muncul ketika keluaran model itu menjadi dasar keputusan yang berdampak pada keamanan dan stabilitas formula — menghitung persentase bahan aktif, menentukan kompatibilitas Retinol dengan asam AHA, atau menilai rentang stabilitas pH sebuah emulsi.
Rekomendasi praktis
Untuk tugas rutin — memeriksa konsentrasi pengawet, mencari sinonim INCI, memverifikasi kelas fungsional bahan — alat berbasis RAG dengan basis data INCI terverifikasi memangkas jumlah kesalahan berkali-kali lipat dibandingkan model generatif tanpa lapisan retrieval. Namun hal ini tidak menghilangkan kebutuhan untuk membaca jawaban secara kritis: bahkan dengan arsitektur RAG, tetap penting memeriksa sumber apa yang dikutip sistem, dan tetap berhati-hati terhadap situasi yang dijelaskan pada bagian keterbatasan pendekatan ini — catatan yang usang, sumber yang saling bertentangan, bahan langka tanpa cakupan basis data yang cukup.
Kriteria intinya sederhana: kepercayaan terhadap alat AI untuk menganalisis formula kosmetik harus tumbuh sebanding dengan transparansi sumbernya, bukan dengan seberapa meyakinkan nada bicaranya. Alat yang jujur mengatakan "saya tidak yakin, tidak ada data terkini tentang bahan ini di basis data" lebih berharga daripada alat yang dengan percaya diri menyebutkan konsentrasi yang sebenarnya tidak ada. Bagi para pengembang yang ingin memahami kimia formula secara sistematis sekaligus belajar bekerja dengan alat semacam ini, ada baiknya memulai dengan kursus dasar tentang analisis INCI dan formulasi — itulah basis pengetahuan yang memungkinkan Anda membedakan jawaban AI yang benar dari halusinasi, bahkan tanpa memeriksa sumber primer.
Anda bisa melihat sendiri perbedaan ini di Walker Formulation Academy Club: AI Chemist menjawab berdasarkan basis data INCI/CosIng yang terverifikasi, bukan dari "memori" model serba guna — dilengkapi juga dengan instruktur langsung dan ulasan atas formula Anda sendiri.